
1.6 万亿参数、全程没碰英伟达:美团 LongCat-2.5 开源权重,把国产算力栈的底牌摊在了桌面上
2026 年 11 月 15 日,美团 LongCat 团队以 MIT 许可放出 LongCat-2.5 完整权重:1.6 万亿总参数、每词元激活约 480 亿,支持 100 万 token 上下文,原生多模态。更关键的是其训练与部署全程基于国产芯片,参考方案用 194 张昇腾 Atlas A2 跑通。本文拆解这套国产算力栈的真实含金量与企业自部署的账。
- LongCat-2.5 总参数规模(MoE,每词元激活约 480 亿)
- 1.6 万亿
- 参考部署所用的昇腾 Atlas A2 加速器数量
- 194 张
- 权重开放许可,允许商用、修改与再分发
- MIT
- 美团自测 Terminal Bench v2.1 得分(独立验证尚待观察)
- 88.4
要点速览
2026 年 11 月 15 日,美团 LongCat 团队按 MIT 许可在 Hugging Face 发布 LongCat-2.5 完整权重,允许商用、修改与再分发。
模型为原生多模态 MoE 架构,总参数 1.6 万亿、每词元激活约 480 亿,支持 100 万 token 输入上下文、最多 12.8 万 token 输出。
模型接受文本、图像、视频输入并输出文本,可开关推理;API 同时兼容 OpenAI 与 Anthropic 格式,可接入 Claude Code、Codex、Hermes。
据美团披露,模型训练与微调全程使用国产芯片,未使用英伟达 GPU;前代 LongCat-2.0 于 6 月底在超过 5 万张国产 AI 芯片集群上训练。
参考自部署方案基于 194 张昇腾 Atlas A2:2 张处理图像、64 张摄取提示、128 张生成响应,未给出英伟达 GPU 部署指引。
W4A4 量化(专家权重与激活 4bit)在美团负载测试中相比 8bit 版本,prefill 吞吐提升约 43.3%、decode 吞吐提升约 42.77%,精度相当。
美团自测 Terminal Bench v2.1 得分 88.4,接近 Claude Opus 5 的 89.1 与 GPT-5.6 Sol 的 88.8;这些为厂商自测,独立验证尚未出现。
黄鹂鸟视角:权重开源降低的是「拿到模型」的门槛,没有降低「跑好模型」的难度——工程栈与数据治理仍是分水岭。
本期三块拼图
模型、国产算力栈与企业工程底座——开源权重落地的三层结构
LongCat-2.5
美团 LongCat 团队 · MIT 许可的万亿级智能体模型
- MoE 架构,1.6 万亿总参数、每词元激活约 480 亿
- 100 万 token 上下文,最多 12.8 万 token 输出
- 原生多模态,文本 / 图像 / 视频输入
国产算力栈
昇腾 + SGLang NPU · 194 卡跑通的完整部署答案
- EPD 分离式架构:编码 / 预填充 / 解码
- W4A4 量化,prefill 与 decode 吞吐各提升约 43%
- 全程无英伟达 GPU 的训练与 serving 路径
企业大模型应用平台
黄鹂鸟科技 · 把开源权重变成可用服务
- 私有化推理与统一模型网关
- 知识库沉淀行业语料与规范
- 调用审计与成本可核算
从发布到开源
LongCat-2.5 从模型发布到权重开放的约两周
- 2026 年 11 月 2 日
美团正式发布 LongCat-2.5 模型,主打长程智能体与原生多模态
- 2026 年 6 月
前代 LongCat-2.0 在超过 5 万张国产 AI 芯片集群上完成训练
- 2026 年 11 月 15 日
The Decoder 等媒体报道模型性能接近西方头部模型,引发关注
- 2026 年 11 月 15 日
美团按 MIT 许可在 Hugging Face 放出完整权重与 4bit 量化版本
- 2026 年 11 月 15 日
参考部署方案披露:194 张昇腾 Atlas A2 与 W4A4 量化的吞吐数据
- 2026 年 11 月 16 日
本文梳理:国产算力栈的完整度,以及企业自部署的真实门槛
一个「反常识」的开源:1.6 万亿参数,全程没碰英伟达
在大模型圈子里,万亿参数模型几乎等同于英伟达集群——这几乎是默认设定。所以当美团 LongCat 团队在 2026 年 11 月 15 日按 MIT 许可放出 LongCat-2.5 完整权重,并明确表示训练与微调全程使用国产芯片、未使用英伟达 GPU 时,这件事的意义就超出了「又一款开源模型」。
据 The Decoder、PANews、GPTOnline 等多家媒体交叉报道,LongCat-2.5 是一个原生多模态混合专家模型,总参数 1.6 万亿,每处理一个词元激活约 480 亿参数,通过 API 支持最多 100 万 token 的输入上下文,单次输出上限约 12.8 万 token。
更值得关注的是时间线:模型在 11 月 2 日正式发布,约一周后权重才公开。也就是说,这次事件的核心不是「模型首发」,而是「权重与部署方案一起开放」——把能不能拿到、能不能跑起来这两个问题,一次性摆到开发者面前。
MIT 许可的分量也不轻。它允许商用、修改与再分发,几乎没有额外的授权摩擦。对照近期一些带地域门槛或营收门槛的「开放权重」许可,MIT 的简洁反而成了稀缺品,对企业法务和合规团队格外友好。
需要保持冷静的是,性能数字目前主要来自美团自测。多家报道都提醒,独立验证尚未出现,限时 API 价格也可能调整。把这些 caveat 一并看进去,才是对待一次开源发布应有的姿态。
还有一个容易被忽略的细节:这次同时放出的是完整 BF16 权重与一个独立的 4bit 量化版本,两个仓库都在 Hugging Face 上。对开发者而言,这相当于把「追求精度」和「追求效率」两条路线的入口都准备好了,不必自己在量化环节从零摸索,验证周期因此被明显压缩。
LongCat-2.5 到底是什么样的模型
从架构看,LongCat-2.5 是典型的稀疏 MoE 模型:总参数 1.6 万亿,但每个词元只激活约 480 亿。稀疏激活的意义在于,模型容量可以做得很大,而单次推理不必为全部参数付算力,这对控制成本至关重要。
多模态的实现方式有讲究。据公开的模型说明,它不是外挂一个独立的视觉编码器,而是把原生分辨率的图像转换为离散的视觉 token,与主Transformer 中的文本 token 一起在统一语义空间里处理。这样做的好处是视觉信息能更深入地参与推理,对视觉编码、设计与 3D 相关任务更有利。
输入输出方面,模型接受文本、图像和视频,输出文本,并允许开关推理模式。对长程智能体任务来说,能按需切换「想深一点」和「直接答」,是在成本与效果之间做平衡的常见做法。
API 兼容性是另一个贴心设计:同时支持 OpenAI 与 Anthropic 两种格式,可直接接入 Claude Code、Codex、Hermes 等智能体框架。对企业而言,这意味着替换底层模型时,上层工具的改动可以压到很小。
训练方法上,美团称用真实 GitHub Pull Request 任务构建强化学习题目,并复现智能体失败场景。为防止「奖励作弊」,训练沙箱切断了互联网、Git 历史与构建缓存,还用一个语言模型裁判检查解答是否走了捷径。这类细节,往往比分数更能反映工程扎实的程度。
194 张昇腾怎么跑起来:EPD 分离式架构拆解
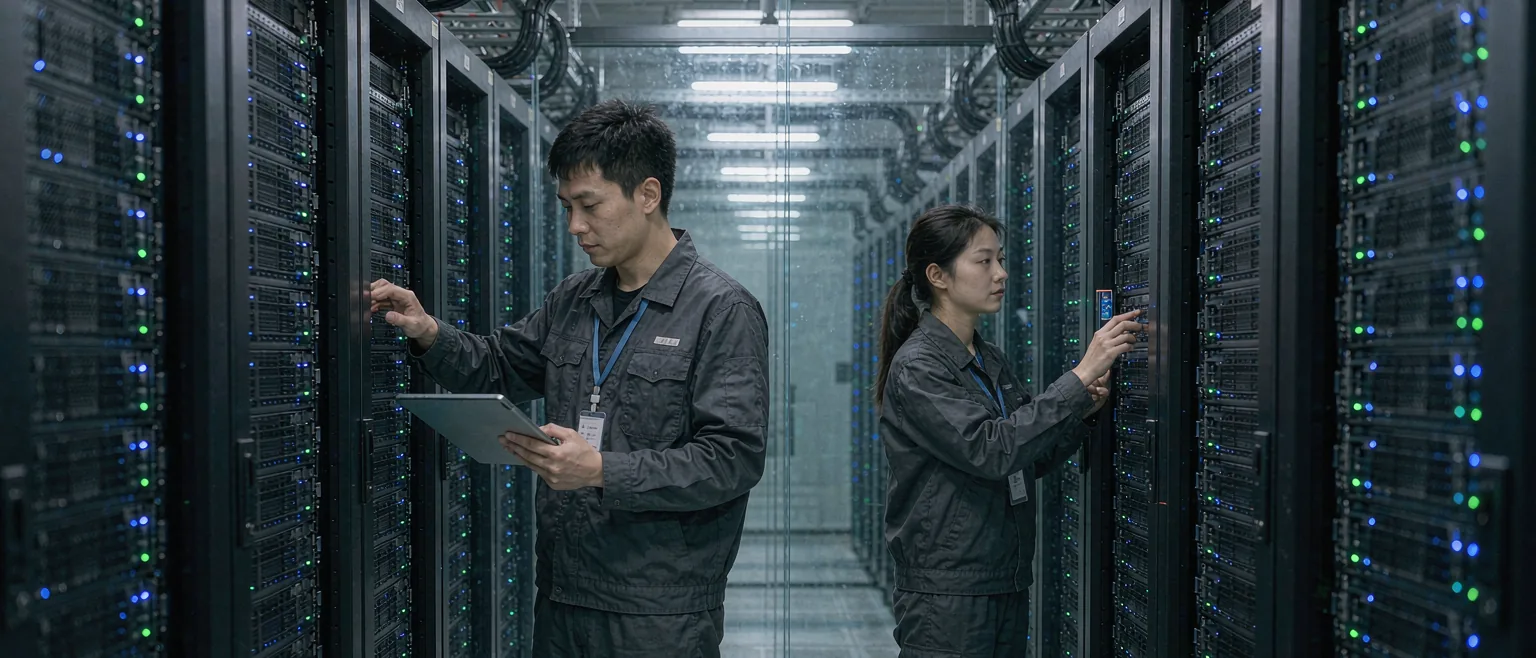
开源权重只是第一步,能不能跑起来才是企业真正关心的问题。美团给出的参考自部署方案,基于 194 张华为昇腾 Atlas A2 加速器:2 张负责原生图像 token 化,64 张负责提示摄取,128 张负责自回归响应生成。
这套分工对应的是 EPD 分离式架构——把编码(Encoder)、预填充(Prefill)和解码(Decode)三个阶段拆开部署。之所以要拆,是因为这三个阶段的资源特征完全不同:预填充偏计算密集,解码偏访存密集,混在一起会互相拖累。
分开部署后,每个阶段可以按自己的特点配置卡数和调度策略,整体资源利用率更高。公开信息提到,这套方案运行在定制的 SGLang NPU 推理栈上,针对非 Blackwell 类芯片的内存带宽限制做了工程优化。
值得注意的是,美团没有提供任何英伟达 GPU 的部署指引。这既是对「全程国产芯片」叙事的坚持,也意味着习惯了 CUDA 生态的团队需要重新熟悉一套工具链。迁移成本客观存在,不能因为模型开源就忽略。
对国内企业来说,这套方案的价值在于给出了一个完整、可参照的样本:从卡数配比到阶段拆分,从量化格式到推理栈,都写得很具体。相比只放权重不谈部署的开源,这种「连答案一起给」的方式更实用。
W4A4 量化:4bit 换来的 43% 吞吐从哪来
量化是让大模型跑得起的关键手段。LongCat-2.5 在专家权重和激活上都采用了 4bit 的 W4A4 量化格式,而这类格式恰好能被国产芯片原生计算,不需要先反量化再算,从而省下大量搬运和转换开销。
美团公布的负载测试数字很具体:相比 8bit 版本,W4A4 在提示预填充阶段吞吐提升约 43.3%,在解码阶段提升约 42.77%,同时精度与未压缩模型相当。两个数字都接近 43%,说明优化是系统性的,而不是某一环节的局部收益。
为什么 4bit 能带来这么大提升?核心是内存带宽。大模型推理常常不是算不过来,而是数据从显存搬到计算单元太慢。权重和激活都压到 4bit,搬运量大幅减少,带宽压力随之下降,吞吐自然上来。
这对企业自部署的意义很直接:同样的硬件能服务更多请求,单位 token 成本下降。对预算有限的团队,量化往往比加卡更划算——当然前提是精度损失在业务可接受范围内。
不过,"精度相当"是厂商在自身测试集上的结论。企业在采用量化版本前,仍应用自己的典型任务做一轮对比评测,尤其要关注长尾任务和专业领域的表现,避免平均指标掩盖了关键场景的退化。
W4A4 量化让 prefill 与 decode 吞吐各提升约 43%——同样的硬件服务更多请求,但精度仍需用自己的业务样本复核。
88.4 分怎么写:看懂自测分数的正确姿势
多家媒体报道都提到了同一组数字:在 Terminal Bench v2.1 上,LongCat-2.5 得分 88.4,略低于 Claude Opus 5 的 89.1 和 GPT-5.6 Sol 的 88.8,低于 DeepSeek V4.1-Flash 的 90.6。单看排名,似乎是「接近第一梯队」。
但在更难的 Terminal Bench v4.0 上,模型得分 38.5,高于 GPT-5.6 Sol 的 37.3,却明显低于 Opus 5 的 53.9。在 DeepSWE 上得分 64.6,相比前代的 9.7 是巨大跃升,但仍低于 DeepSeek V4.1-Flash 的 74.2。
这组数字放在一起,讲出的故事比「88.4 接近第一梯队」复杂得多:在特定版本和特定任务上表现亮眼,在更难、更综合的基准上仍有差距。只看最好看的那个数字,很容易得出过于乐观的结论。
还有一个必须说明的限定:这些分数主要来自美团自测,多家报道都明确指出独立验证尚未出现。BrowseComp 上的 91.9 分更是在美团自己的测试环境中取得,横向可比性需要打折。
所以对企业来说,正确的姿势是:把厂商分数当作选型的第一层筛选,而不是最终结论。真正决定要不要换模型的,是它在你自己的任务、你自己的数据上的表现——那才是与你业务相关的分数。
MIT 许可与限时价格:企业自部署的真实账本
开源许可是这次发布最实在的利好之一。MIT 许可意味着企业可以自由商用、修改和再分发权重,不必担心营收门槛、署名要求或地域排除。对法务团队来说,这类简洁许可的审查成本最低,落地阻力最小。
API 方面,发布期限时价格约为每百万输入 token 0.27 欧元、每百万输出 token 1.07 欧元。多家报道都提醒这是限时促销价,后续可能调整,开发者应以官方价格页为准。把促销价当成长期成本做预算,是很常见的坑。
自部署则是另一本账。194 张昇腾 Atlas A2 的参考配置,显然不是中小企业能轻松承担的门槛起步;再加上机房、运维、电力与人力成本,自建的完整拥有成本并不低。开源省的是授权费,不是基础设施费。
因此在做「自部署还是调 API」的决策时,建议先算清楚三件事:预期的调用规模、数据合规要求、以及团队对国产算力工具链的熟悉程度。规模大、数据敏感、有运维能力的团队更适合自建;反之,先用 API 验证价值更稳妥。
还有一条中间路线值得考虑:用私有化推理平台承载开源权重,配合统一网关做多模型路由。这样既能保留数据不出域,又不必一上来就按最大规模配置硬件,可以随业务增长逐步扩容。
从「能训」到「能开」:国产算力栈的完整度检验
这次事件最值得记录的价值,或许不在模型本身,而在它展示的国产算力栈完整度。过去谈国产替代,常被质疑「能训不能推」「能跑不好用」「缺生态工具链」;LongCat-2.5 给出的答案,是针对这些质疑的一次具体回应。
从训练端看,前代 LongCat-2.0 已在超过 5 万张国产 AI 芯片的集群上完成训练,说明大规模训练的工程能力已经积累。从推理端看,194 卡参考方案、W4A4 量化、SGLang NPU 推理栈,把「怎么部署」讲得很细。
从生态端看,API 兼容 OpenAI 与 Anthropic 格式、可接入主流智能体框架,降低了迁移门槛。训练、推理、工具链、接口标准四个环节连起来,才构成一条真正可用的技术栈,而不是零散的单点突破。
当然,完整度不等于成熟度。一套技术栈是否经得起大规模、长时间的生产检验,还需要更多真实案例和时间来验证。独立评测的缺位、生态工具链的丰富度、跨硬件的可移植性,都是后续要观察的维度。
但对国内企业而言,至少多了一个可规划、可预期的选项。当算力供给存在不确定性时,手上有不止一条可行路径,本身就是一种风险对冲。这种战略价值,往往比一时的分数高低更长久。
黄鹂鸟视角:权重开源之后,落地仍是系统工程
我们的判断一贯如此:开源降低的是「拿到模型」的门槛,从来没有降低「跑好模型」的难度。权重下载下来只是起点,真正让它在业务里产生价值,靠的仍是一整套工程与治理能力。
第一是推理部署。开源权重要变成稳定服务,需要处理量化、调度、弹性伸缩与故障恢复。没有统一的模型网关和私有化推理能力,模型很容易停在实验环境,进不了生产。
第二是知识沉淀。万亿参数模型 knowledge 广博,但不了解你企业的术语、规范与历史案例。用知识库管理系统把行业语料、处置流程沉淀下来,通过检索或微调喂给模型,能力才会从「通用」变成「懂你」。
第三是审计与治理。模型参与真实业务后,每次调用都要可追溯:输入是什么、输出是什么、有没有人工干预、产生了什么动作。这既是对内管理的要求,也是合规审查的基础。
一句话:LongCat-2.5 把「国产模型能不能做到第一梯队」这个问题往前推了一步;而把它变成企业看得见的效率提升,靠的仍是网关、知识库与治理这些朴素工程。模型开源了,落地依然是系统活。
权重开源降低的是「拿到模型」的门槛,没有降低「跑好模型」的难度——网关、知识库与治理仍是分水岭。
把趋势落成系统
文中反复强调的前提——数据在线化、流程结构化——正是下面这些系统在解决的事
常见问题
采用 MIT 许可,允许商用、修改与再分发,没有营收门槛、署名要求或地域排除,法务审查成本较低。需要注意的是限时 API 价格可能调整,预算应以官方价格页为准。
看懂了趋势,下一步是选对系统
告诉我们你的行业、团队规模和最想自动化的环节,我们从 866 条产品线里帮你匹配合适的管理系统, 或按需求定制开发——并为 AI 接入预留好规范的数据接口。
7×24小时在线
把文章里的思路,落成你的系统方案
留下行业与业务规模,我们免费给出针对性的选型建议与实施路径
服务保障
- 免费需求分析
- 按行业匹配系统
- 实施方案透明
- 7×24 技术支持