
从蛋白质到催化剂:2026 大模型把科研搬进「加速期」,企业研发范式正在重写
2026 年,大模型从「写文案」走向「做科研」:预测蛋白质结构、生成新材料与催化剂、加速新药候选。本文拆解 AI for Science 为何成为最受资本与政策青睐的 AI 落地方向,企业研发怎么接,以及数据治理为何是先决条件。
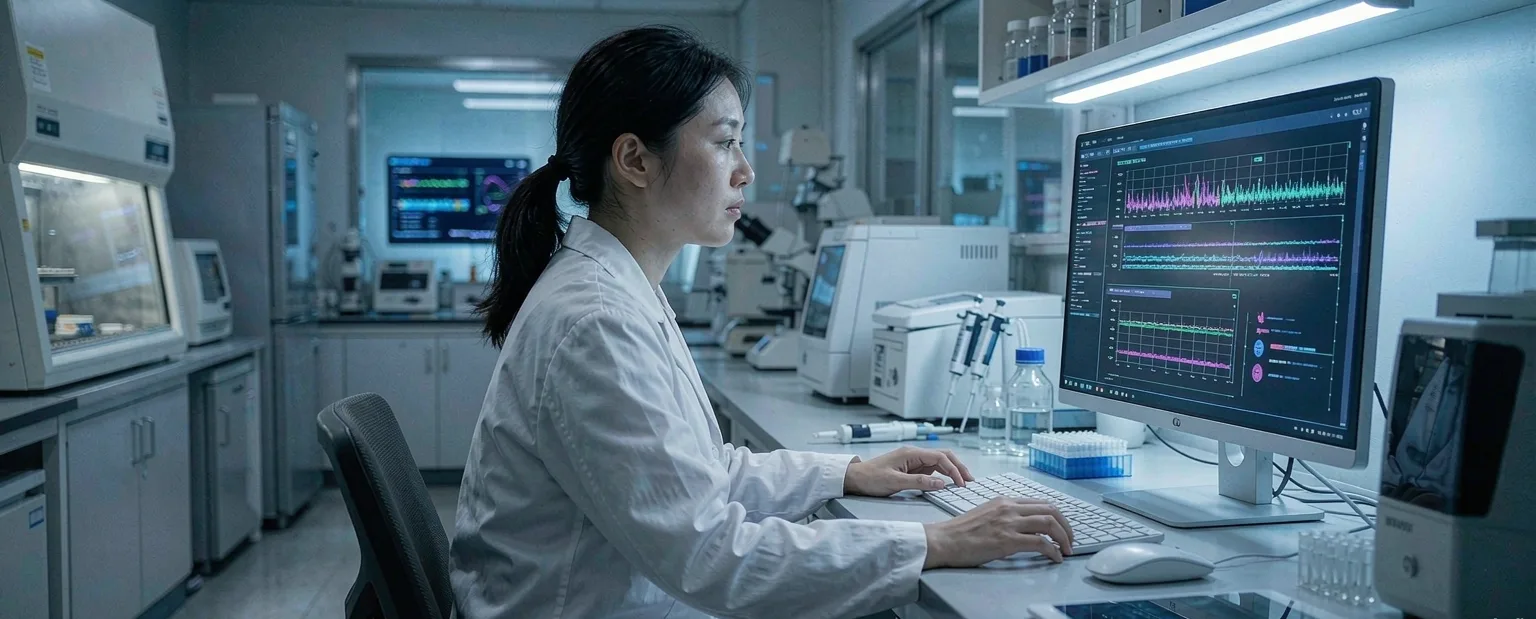
- 从预测蛋白质三维结构到生成材料与催化剂,AI 接管「找结构」环节
- 结构
- 新药发现从「试错十年」被压缩到「候选数月」的公开行业目标
- 候选
- 科研 AI 化的先决条件:实验数据要可结构化、可复现、可喂给模型
- 数据
- 科学场景对「幻觉」零容忍,评测与可解释是硬门槛
- 可复现
要点速览
2026 年,大模型的应用重心从内容生成延伸到科学发现:预测蛋白质结构、生成新材料与催化剂、加速新药候选,被统称为 AI for Science。
AlphaFold 等工作的示范效应显著:结构预测从「耗年」变成「秒级」,2024 年相关突破获得诺贝尔奖,把科研 AI 化推上主流视野。
材料与催化剂是下一步热点:用生成式模型在化学空间里搜索更稳定、更高效、更低成本的结构,替代部分试错实验。
药物研发是最被看好的落地场景:从靶点发现、分子生成到候选筛选,AI 把「试错十年」的目标周期向「候选数月」推进。
基因组与生命科学基础模型进场:用海量生物序列训练的基础模型,开始服务于变异解读、蛋白设计与合成生物学。
门槛在算力与数据两端:训练科研大模型吃高端算力,而真正稀缺的是高质量、可复现、带标注的实验数据。
企业研发要接,先把实验数据治理好:把分散在仪器、表格、论文里的数据整理成模型可喂的结构化燃料,是第一步。
黄鹂鸟视角:科研 AI 化不是买个模型就行,而是补「数据治理 + 私有化推理 + 合规留痕」这一课,模型才能可信落地。
本期三块拼图
结构生成模型、生命科学基础模型与企业底座——让大模型从「写文案」走向「做科研」
结构预测与生成模型
科研基础模型 · 从预测结构到生成结构
- 蛋白质 / 材料 / 催化剂结构
- 在化学与生物空间搜索
- 替代部分试错实验
基因组 / 生命科学基础模型
生命科学与 AI 交叉 · 读懂序列与变异
- 海量生物序列训练
- 变异解读与蛋白设计
- 服务合成生物学
企业大模型应用平台
黄鹂鸟科技 · 让科研模型可信落地
- 私有化推理与数据不出域
- 数据治理对接实验系统
- 调用与结果可审计、可复现
科研 AI 化的一年
2026 年,大模型从内容生成外溢到科学发现,成为最受青睐的 AI 落地方向
- 2024 年
蛋白质结构预测的重大突破获得诺贝尔奖,把「AI 做科研」推上主流视野
- 2026 年 2 月
多家机构发布面向材料与催化剂生成的科研基础模型,化学空间搜索提速
- 2026 年 5 月
基因组与生命科学基础模型密集披露,服务于变异解读与蛋白设计
- 2026 年 7 月
药物研发领域把「候选数月」作为 AI 辅助发现的公开目标被广泛讨论
- 2026 年 9 月
政策与资本持续加码 AI for Science,视为最具确定性的 AI 落地方向之一
- 2026 年 11 月 11 日
本文梳理:科研大模型为何成为热点,企业研发怎么接,数据治理为何是先决条件
科研的「慢」与 AI 的「快」
科研是典型的「慢变量」:一个新材料从设想、合成到验证,往往以年计;一款新药从靶点到临床,常以十年计。慢的根因不是人不努力,而是探索空间太大、试错成本太高。
大模型擅长的事,恰恰是把「在巨大空间里找答案」这件事提速。它不替代科学家,而是把最耗时的「猜结构、排候选、筛无效」环节交给机器先跑一遍,让人把时间投到真正需要判断的地方。
这种提速度不是噱头。以蛋白质结构预测为例,过去解析一个结构可能要数月实验,模型把这件事压缩到近乎即时,相关突破在 2024 年获得诺贝尔奖,把「AI 做科研」彻底推上主流视野。
2026 年的新变化是:这套逻辑正从生命科学外溢到材料、化学、制药等更广的科研战场。AI 不再只是写文案的助手,而开始成为实验室里的「协作者」。
蛋白质之后:材料、催化剂、分子的生成式发现
结构预测只是起点。更诱人的是「生成」:给定一组性能目标(更稳定、更高效、更便宜、更环保),模型直接在化学与材料空间里生成满足条件的候选结构。
催化剂是典型例子。工业催化长期靠经验与试错,而生成式模型能在海量组分组合里搜索更优配方,缩短从设想到大样的周期,对能源、化工、电池等行业都有想象空间。
材料发现同理。从半导体到合金,从涂层到吸附剂,「按性能反推结构」的生成式范式,正在替代部分纯实验搜索。模型给出的不是最终答案,而是一份「更值得先试」的候选清单。
关键在于把「生成」和「验证」闭环起来。模型负责收窄搜索范围,实验负责确认,二者反复迭代,整体效率远高于纯试错。AI 的价值,是让每一次实验都打在更有可能的地方。
药物研发:从「试错十年」到「候选数月」
药物研发是科研 AI 化最被看好的场景,也最烧钱、最漫长。传统路径里,绝大多数候选分子会在临床前或临床阶段折戟,沉没成本惊人。
AI 的切入点贯穿全程:靶点发现阶段帮着从海量文献与组学数据里找关联;分子生成阶段按成药性约束设计新结构;筛选阶段用预测模型淘汰明显无效的候选,把实验资源留给更有希望的。
行业里「候选数月」被当作 AI 辅助发现的公开目标反复提及——不是说新药几个月上市,而是把「拿到值得进临床的候选」这一步大幅提速,后面的临床仍要扎实走完。
越是强调这一点,越要克制。AI 缩短的是「找方向」的时间,不是「证明安全有效」的时间。把模型当放大镜而非免责牌,才是负责任的态度。
基因组与生命科学:基础模型进场
生命科学是科研大模型的天然训练场:DNA、RNA、蛋白质都是序列,天然适配「下一个 token 预测」这类范式。2026 年,面向基因组与蛋白的基础模型密集披露。
它们的能力包括:读懂变异意味着什么、设计具有特定功能的蛋白、辅助合成生物学的线路搭建。换句话说,模型开始从「看懂生命」走向「改写生命」。
这对医疗、农业、酶工程都有潜在价值。但越是贴近生命,越要谨慎:一个错误的蛋白设计可能带来不可逆后果,评测、可解释与伦理边界必须同步跟上。
基础模型的意义在于「通用底座」。它不只为某一病某一酶服务,而是成为整个生命科学研发的共享基础设施,下游团队在其上做微调与专用,边际成本快速下降。
训练这些模型:算力与数据的双门槛
科研大模型的门槛在两端。算力端,训练前沿模型需要高端 GPU 集群与稳定电力,是资本与基建的硬较量;推理端相对友好,一旦训好,调用成本可控。
但真正稀缺的是数据,不是算力。高质量实验数据往往散落在仪器日志、Excel、论文附图、甚至研究者的笔记里,格式不一、口径混乱、还常常带版权与隐私约束。
没有干净数据,再强的模型也是空转。科研 AI 化的第一道坎,不是「买不买得起模型」,而是「企业的实验数据能不能被模型吃进去」。
这也解释了为什么很多机构卡在 PoC:模型 demo 很亮眼,一接自家数据就哑火。数据治理,是科研 AI 化绕不过去的前置工程。
企业研发怎么接:把实验数据变成可喂的燃料
企业想上科研 AI,最务实的路径不是先追最前沿的模型,而是先把数据底座收拾好。把分散在各处的实验数据统一采集、清洗、标注、脱敏,变成模型可喂的结构化燃料。
第二步是把模型接进实验系统:让预测结果能直接生成实验方案、回写结果、形成「预测—实验—再训练」的闭环,而不是人肉搬运模型输出。
第三步才是上模型。私有化推理保证敏感配方与实验数据不出域;统一网关让底层科研模型可替换,避免被单一供应商锁死。
一句话:先补数据治理这一课,再谈模型。底座对了,模型只是上面的一层能力;底座错了,模型越多越乱。
风险:可复现、可解释与「幻觉」的代价
科研场景对「幻觉」零容忍。写错一段文案顶多尴尬,预测错一个催化剂结构可能浪费数月的真实实验。所以评测与可解释不是加分项,而是准入门槛。
可复现是另一条红线。模型给出的结构,必须能被独立实验验证;不能验证的「漂亮结果」在科学上无意义。这要求全流程留痕:用了什么数据、什么模型、什么参数、得出什么结论。
还有知识产权与合规。用谁的实验数据训练、生成的结构归谁、是否涉及受管控的生物设计,都需要在合规框架内厘清,不能「先生成再补手续」。
负责任的态度是:把 AI 当协作者而非裁判。它收窄搜索、提出建议,最终结论与放行仍由具备资质的人与流程把关。技术越强,人的责任越重。
黄鹂鸟视角:科研 AI 化,先补数据治理这一课
我们的判断很直接:科研 AI 化不是买个模型就完事,而是先补「数据治理 + 私有化推理 + 合规留痕」这一课。模型随时能换,底座不能天天重搭。
落地推荐三件套:用数据治理平台把实验数据整理成可结构化的可信燃料;用企业大模型应用平台做私有化推理与统一网关,让科研模型数据不出域、可替换;用知识库沉淀实验规范与文献,让模型有据可依。
底座铺好之后,再去谈「上哪个科研模型、接哪个实验系统」,才不会从零开始。科研 AI 的红利在闭环,不在单点演示。
给研发负责人一句话:别被「最前沿模型」的叙事带走。先问三件事——数据能不能喂、结果出不出域、结论谁来把关。三关过了,科研 AI 才是生产力。
科研 AI 化的先决条件不是模型,而是数据:先把实验数据治理成可信燃料,模型才能落地。
给不同研发团队的落地清单
高校与研究院:从已有公开数据集 + 开源科研模型起步,跑通「预测—实验验证」小闭环;重点沉淀可复现的实验记录,为后续规模化打底。
企业研发中心:先把实验数据治理提上日程,统一采集与标注;选一个高价值窄场景(如某类材料筛选)做试点,证明周期压缩后再扩。
强监管行业(医药、生物):上私有化底座,敏感数据不出域;评测、可解释与留痕齐全,模型建议交人工与合规流程双把关。
规模不同,起点不同,但终点一致:数据要可信可喂、模型要出得去管得住、结论要有人兜底。离开这三点,再炫的科研大模型都是空中楼阁。
把趋势落成系统
文中反复强调的前提——数据在线化、流程结构化——正是下面这些系统在解决的事
常见问题
可以分步走。先用公开数据集与开源科研模型做窄场景试点,把「预测—实验验证」小闭环跑通;算力走按需推理,不一定要自建训练集群。门槛主要在数据治理,而非模型本身。
看懂了趋势,下一步是选对系统
告诉我们你的行业、团队规模和最想自动化的环节,我们从 866 条产品线里帮你匹配合适的管理系统, 或按需求定制开发——并为 AI 接入预留好规范的数据接口。
7×24小时在线
把文章里的思路,落成你的系统方案
留下行业与业务规模,我们免费给出针对性的选型建议与实施路径
服务保障
- 免费需求分析
- 按行业匹配系统
- 实施方案透明
- 7×24 技术支持