
AIOps 运维智能体上岗:告警风暴被压下去、根因一推就中,运维终于不用半夜爬起来
2026 年 11 月,AIOps 运维智能体从监控告警走向真实生产:告警噪声收敛、根因定位与自动处置开始由智能体协同完成。本文拆解它为什么先落在运维、能接哪几类活,以及企业怎么把它接进 ITAM 与统一监控而不失控。
- 运维智能体最先要解决的噪声过载问题
- 告警风暴
- 从「猜」到「推」,定位更快更准
- 推根因
- 自动处置需人工确认,智能体不替人拍板
- 可撤回
- 运维数据不出域是接入的前置条件
- 私有化
要点速览
2026 年,AIOps 运维智能体从监控告警走向真实生产,最先落地的三件事是告警收敛、根因定位与自动处置。
告警风暴是运维的头号痛点:海量重复与抖动告警淹没真问题,智能体把噪声压下去、把关联聚起来。
根因定位把指标、日志、链路与拓扑关联,由模型推演最可能的故障点,从「猜」变成「推」。
自动处置让智能体先跑沉淀好的处置脚本,人再确认,把常见故障的恢复时间压下来。
运维 AI 的真正价值不是替代运维,而是把重复分析与低级处置接走,让人聚焦在架构与预防。
落地前提是可观测性与资产在线化:指标、日志、链路与资产拓扑先在监控与 ITAM 里结构化。
风险在于权限与边界:智能体只能动它该动的,敏感操作必须人工确认、可撤回、可审计。
黄鹂鸟视角:AIOps 要接得进 ITAM 与统一监控,统一模型网关与私有化推理决定它能否安全进内网。
本期三块拼图
收敛、定位与资产底座——让 AI 接得进运维,先把可观测数据搬上线
告警收敛智能体
模型能力 · 把噪声压下去
- 重复与抖动告警聚类
- 关联告警归并
- 真问题自动浮出
根因定位智能体
推理能力 · 从猜到推
- 指标/日志/链路关联
- 结合拓扑推演根因
- 给出可验证假设
IT资产管理系统(黄鹂鸟)
黄鹂鸟科技 · 让智能体接进底座
- 资产与拓扑在线化
- 权限与操作边界可控
- 处置留痕可审计
运维 AI 的一个月
从 10 月 21 日到 11 月 14 日,运维智能体从监控告警走向真实生产
- 2026 年 10 月 21 日
多家运维与监控平台发布 AIOps 智能体,把大模型接进告警收敛与根因分析
- 2026 年 10 月 29 日
行业讨论把运维智能体定义为「可观测数据之上的推理与处置协作者」
- 2026 年 11 月 3 日
自动处置从「建议」走向「执行」,强调敏感操作人工确认与可撤回
- 2026 年 11 月 8 日
端侧与私有化 AIOps 升温,强调运维数据本地处理与权限隔离
- 2026 年 11 月 12 日
本期梳理:运维智能体进生产的真实能力与边界
- 2026 年 11 月 14 日
本文发布:运维如何从告警风暴里抬头,把判断留给 AI 之外的自己
IT 运维为什么是智能体的天然场景
运维这一年变化很快:从靠人盯大屏、刷日志,变成了能收敛告警、定位根因、甚至跑处置脚本的协作者。这个落点不是偶然。
运维场景有三个特点,恰好是智能体的甜区:数据高度密集、规则相对清晰、重复分析极多。前两个让智能体有活干,第三个让它有不可替代的价值。
一个系统的故障,信号散在指标、日志、链路和工单里,同一次异常可能触发几十条告警。人肉拼图既慢又漏,而智能体最擅长做这种跨源整理与关联。
所以运维智能体的第一站不是取代谁,而是补洞——把割裂的可观测信号收拢成可执行的结构,让运维少花时间找原因、多花时间做预防。
放到 2026 年,运维智能体的成熟度已经够它进生产:告警聚类、日志理解、拓扑推理这些单点能力已经稳,缺的是把它们编排进运维流程的工程底座。
它先接哪几类活:告警、根因与处置
运维智能体最先落地的三类活很具体。第一类是告警收敛:把重复、抖动与关联告警聚类,把真问题从噪声里浮出来。
第二类是根因定位:把指标、日志、链路与拓扑关联,由模型推演最可能的故障点,从「猜」变成「推」。
第三类是自动处置:让智能体先跑沉淀好的处置脚本,人再确认,把常见故障的恢复时间压下来。
这三类活的共同点是低风险、高重复、强依赖上下文。它们不需要智能体替人拍板,只需要它把信号整理清楚、把建议送到。
对企业来说,先从这三类落地最稳:价值立竿见影,出错代价可控,也最容易让团队建立对智能体的信任。
告警风暴:把噪声压下去,把真问题浮上来
运维的头号痛点不是没告警,而是告警太多。一次连锁故障能炸出几十条告警,真正的原因反而被淹没,值班人疲于奔命。
智能体做的第一件事就是把噪声压下去:重复告警去重、抖动告警抑制、关联告警归并,让一簇问题只冒一个顶层的信号。
更深一层,它会把同一故障在不同系统里的表现对齐,告诉你「这 20 条其实是一回事」,而不是让你逐条看。
告警收敛的价值不只是清净。它让值班人把注意力放在真问题上,平均故障发现时间随之下降,半夜被叫醒的次数也少了。
但要提醒,收敛不能过度。误把真问题合并掉,比噪声更危险。所以收敛规则要可解释、可回放,运维才敢信。
根因定位:从「猜」到「推」
告警收敛解决「哪里出问题了」,根因定位解决「为什么」。过去这一步靠资深运维凭经验猜,靠翻日志拼线索。
智能体把指标、日志、链路和拓扑放进同一张图里,由模型推演最可能的故障点,并给出可以验证的假设,而不是只甩一句「可能有问题」。
比如一次接口超时,模型能把上游依赖、近期变更、资源水位与错误日志关联起来,指出「是某次发布导致的连接池打满」,而不是让你从零排查。
真正难的是可验证。好的根因不是结论,而是假设加证据,运维可以一键核到对应的指标与日志,三两下确认。
一句话:根因定位从猜变成推,靠的是把可观测数据关联起来。数据越全、拓扑越清,推得越准。
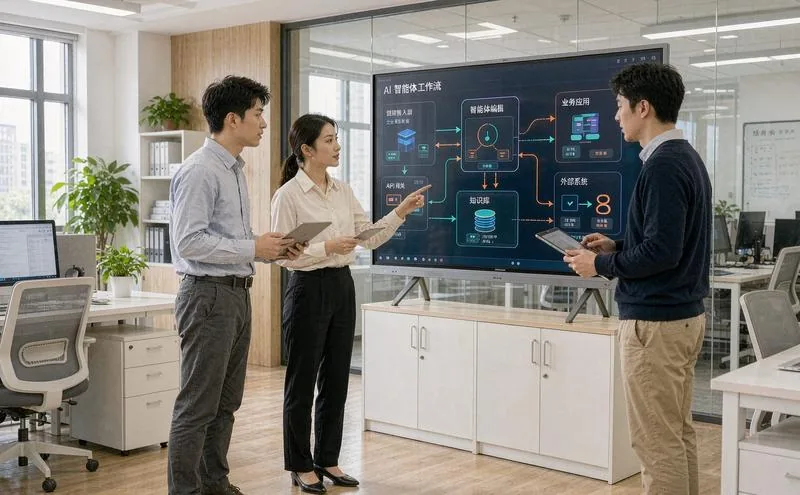
自动处置:让智能体先跑脚本,人再确认
第三类活是自动处置。很多故障的恢复路径是固定的:重启服务、切换节点、回滚发布、扩容副本。这些脚本化处置,正是智能体最擅长接的。
正确姿势是:智能体先按沉淀好的预案跑处置,并把每一步与结果回写工单,关键动作仍需人工确认、可撤回。它跑腿,人把关。
这带来的改变是恢复时间。常见故障从「人醒来看日志、再决定、再操作」变成「智能体先处置、人复核确认」,分钟级恢复成为常态。
但自动处置的红线很硬:权限隔离、操作边界、可审计缺一不可。智能体能动的,必须严格小于人被授权的范围。
一句话:自动处置接走的是低级重复操作,不是决策权。把边界划清,它才从风险源变成好帮手。
可观测性与数据底座:没数据就没有推理
运维智能体最容易被神化的地方,是以为接个模型就能全自动。现实是:没有可观测数据,再聪明的模型也只是空转。
指标、日志、链路与资产拓扑先要在线化、结构化,模型才有可关联的原料。很多团队卡在第一步,恰恰是因为监控散、拓扑乱。
所以 AIOps 的第一步往往是可观测性补课:把监控接入统一、把资产与依赖理顺、把历史故障沉淀成案例库。
底座铺好后,模型才有的学、有的推。这一步是监控平台与 IT 资产管理系统在做的事,也是智能体能不能落地的分水岭。
对企业,选型顺序是:先确认你的指标、日志、链路与拓扑是否在线,再决定上哪家的运维智能体,而不是先追最聪明的模型。
权限与边界:智能体不能替人重启生产
运维智能体最容易被用错的地方,是让它替人做决定。正确姿势是:它只能动它该动的,敏感操作必须人工确认、可撤回、可审计。
比如它可以生成处置建议并预演,但不能擅自重启核心服务;它可以回滚一次发布,但最终确认仍由人完成。边界要写进接入流程。
权限隔离同样关键。智能体能访问的系统范围,应与被代理人一致,不能因为接了 AI 就放大运维暴露面。
可撤回与可审计是兜底:任何由智能体发起的动作,都要留痕、能还原、能撤销。这一步做不好,信任会迅速崩塌。
一句话:运维智能体是跑腿的,不是签字的。把边界划清,它才从风险源变成好帮手。
黄鹂鸟视角:AIOps 要接得进 ITAM 与统一监控
我们的判断很直接:运维智能体能不能用起来,关键在它能不能接进企业既有的监控与资产底座。很多团队接了最强模型,却发现读不到拓扑、动不了资产。
所以落地时,我们建议先用 IT 资产管理系统把资产、依赖与拓扑在线化,让智能体的每一次推理都有可寻址的上下文与可控的边界。
再用企业大模型应用平台做统一模型网关与私有化推理,把运维数据留在内网、调用可审计,智能体才从演示变成可信的协作者。
一句话:运维智能体先落在告警、根因与处置三类活,但前提是数据先在线、边界先写清。底座铺好,AI 才接得进运维。
我们做的事,就是帮企业把这道「运维题」变成「接入题」:无论接国产还是国际模型,先落到统一网关与治理,再谈能力取舍。
运维文化:从救火到预防
关于 AIOps,最该澄清的是它不取代运维工程师。它替人收敛告警、初判根因、跑低级脚本,把人留在架构优化与故障预防上。
运维团队的文化会从「救火」转向「预防」。会写预案、能读懂模型推理、懂得用数据做容量规划的人,价值反而更高。
对团队,AIOps 的收益不是少几个人,而是少几次半夜被叫醒、少几次重大故障,让同样的团队能支撑更复杂的系统。
这意味着运维组织要重新分工:一部分人专注监控与预案的设计,一部分人专注架构与容量,模型负责把重复分析接走。
一句话:运维智能体接走的是低级活,不是人。把人留在需要判断的地方,才是团队扛得住、也愿意用的姿势。
投入产出:AIOps 的账怎么算
企业上 AIOps,最现实的问题是值不值。它的收益不直接体现在少几个人,而体现在更短的故障恢复、更少的误报与更低的值班成本。
可量化的地方有几处:告警噪声下降、平均故障定位时间缩短、自动处置覆盖的常见故障增多。把这些加起来,往往能覆盖系统投入。
但收益的前提是可观测性铺好。若指标、日志、链路与拓扑还散落,模型接进去也跑不出价值,投入产出自然算不平。所以先补课。
一个务实的起步,是先在告警收敛与根因初判上试点,把噪声、定位时长与值班负荷算清,再决定是否扩展到自动处置。
对企业,AIOps 的账要这么算:它省下的是重复分析与隐性故障损失,放大的才是运维真正的预防能力。
别踩这些坑:落地前的三个提醒
第一个坑是底座没铺就上模型。指标、日志、链路与拓扑还散落,模型接进去也跑不出价值,投入产出算不平。
第二个坑是把智能体当替身。让 AI 擅自重启服务、自动处置核心系统,风险会迅速反噬。正确姿势是它跑脚本、人确认。
第三个坑是忽视治理。运维数据不私有化、调用不审计、权限不隔离,再强的模型也扛不住安全与合规的追问。
避开这三个坑,运维智能体才能从演示变成可信的生产力,而不是又一笔交了学费的实验。
还有一个容易被忽视的点:别一次铺太大。很多团队一上来就想全自动处置核心系统,结果边界没划清就出事。建议先从告警收敛这类低风险环节试点,跑通再扩展,比一口气全量上线更稳更可控。
把趋势落成系统
文中反复强调的前提——数据在线化、流程结构化——正是下面这些系统在解决的事
常见问题
不会。它接走告警收敛、根因初判与低级脚本化处置,让人聚焦架构优化与故障预防。涉及核心服务的处置仍需人工确认,责任仍在人手里。
看懂了趋势,下一步是选对系统
告诉我们你的行业、团队规模和最想自动化的环节,我们从 866 条产品线里帮你匹配合适的管理系统, 或按需求定制开发——并为 AI 接入预留好规范的数据接口。
7×24小时在线
把文章里的思路,落成你的系统方案
留下行业与业务规模,我们免费给出针对性的选型建议与实施路径
服务保障
- 免费需求分析
- 按行业匹配系统
- 实施方案透明
- 7×24 技术支持