
给 AI 同事造 1.67 万个真实工位:它缺的不是智商,是一间乱糟糟的办公室
10 月 22 日,腾讯混元与复旦大学公开 WorkForge:先不急着把模型做大,而是造出 16665 个可验证的真实工作区——平均 42.3 个文件、散落在多级目录里、一半以上是表格。用这些环境后训练的 27B 模型在 GDPval 拿到 82.4 分,超过参数量约 15 倍的 397B 模型。本文拆解这套「环境工厂」的四步流水线、真实与合成环境的 5.4 倍差距,以及它对企业最扎心的一条提醒:连可核对的数字都没有,AI 再强也接不了手。
要点速览
10 月 22 日,腾讯混元与复旦大学提出 WorkForge 框架,论文《Scaling Verifiable Environments for Long-horizon Work Agents》同步公开
产出 WorkForge-16K:16665 个可验证工作环境,横跨 40 个专业领域、60 种文件类型,表格数据占 53.31%
每个工作区平均 42.3 个文件、约 279KB;每个任务平均 21.9 条验证标准;一条轨迹平均 31.8 步、33.8 次工具调用、约 7.6 万 token
用真实资源搭出的工作区,文件数是纯模型合成工作区的 5.4 倍,文件类型是 2.4 倍,平均体积从 21.5KB 涨到 279KB
WorkForge-A3B 在 GDPval 从 45.5 升到 73.6、APEX-Agents 从 5.0 升到 21.3;WorkForge-27B 在 GDPval 拿到 82.4,高于 397B-A17B 的 79.7
但最严的长程基准 Agents’ Last Exam 通过率只有 12.4%——演示能跑通,不等于产能可以交付
训练改变的是干活姿势:工具调用失败后,模型的推理长度从 144 个字符涨到 614 个字符,先诊断再重试
这套方案的三块积木
环境、学生模型、验证器——缺一块,轨迹就白跑
WorkForge-16K
环境集 · 真实资源搭建 · 1.67 万个能「查得到答案」的工位
- 16665 个可验证环境,覆盖 40 个专业领域、60 种文件类型
- 工作区平均 42.3 个文件、约 279KB,线索分散在多级目录
- 每个任务平均 21.9 条验证标准,兼顾数值核对与语义评分
WorkForge-A3B
学生模型 · 35B 级 MoE · 把「会聊天」推成「会交付」
- GDPval 从 45.5 提升到 73.6,APEX-Agents 从 5.0 提升到 21.3
- Agents’ Last Exam 通过率 12.4%,同尺寸对照方案为 2.9%
- GDPval 比此前的专用智能体模型高出 38.6 分
WorkForge-27B
后训练模型 · 强基座再提升 · 82.4 分,压过 15 倍参数的大模型
- GDPval 82.4,高于 397B-A17B 的 79.7,低于 Claude Opus 4.8 的 89.1 与 GPT-5.6 Sol 的 90.1
- 五个基准全部提升,WildClaw 提高 8.0 分
- 交付质量细项通过率提升 4.5 至 13 个百分点,视觉排版与数值准确提升最明显
一个「环境工厂」的成型时间线
从评测标准变化,到环境、验证器、轨迹三件套
- 2026 年
智能体评测从「答题」转向「交付物」,GDPval、APEX-Agents、Agents’ Last Exam 等基准把 PPT、表格与多文件核查纳入评分
- 2026 年 10 月 22 日
腾讯混元与复旦大学公开 WorkForge 框架,并发布 WorkForge-16K 环境集
- 2026 年 10 月 22 日
论文《Scaling Verifiable Environments for Long-horizon Work Agents》上线 arXiv,编号 2610.04906
- 2026 年 10 月 22 日
训练细节披露:用 GLM 5.3 配合 Claude Code、OpenClaw 生成示范轨迹,再据此微调 Qwen3.5 系列模型
- 2026 年 10 月 22 日
国内外媒体跟进,讨论焦点从「模型多大」转向「环境多真、验证器多硬」
- 2026 年 10 月 23 日
企业侧开始追问同一个问题:内部系统里到底有没有可核对的事实与可执行的验收标准
「AI 同事」卡住的地方,往往不是智力
过去一年,几乎每一家做大模型的公司都在讲同一个故事:把智能体放进企业,让它像同事一样接活。演示视频里,它三分钟做完一份周报、五分钟整理完一份竞品分析,看起来离「上岗」只差一个账号。但真正把权限开给它的人会发现另一幅景象:文件在十几个目录里、命名规则有三套、同一个指标在两份表里数字不一样,它会很礼貌地交出一份格式漂亮、数字全错的报告。
腾讯混元与复旦大学在 10 月 22 日给出的解释很直接:问题不在模型会不会推理,而在训练它的那些「考题」太干净了。合成环境通常只有一份说明文档、一个脚本、一份示例数据,答案几乎摆在明面上;真实职场则相反,线索散落、口径冲突、缺页少行,员工的大部分时间花在找证据和核对上,而不是写结论。
于是他们换了个思路:先不急着把模型做大,先把「工位」造出来。这套名为 WorkForge 的框架,核心不是模型结构,而是一条把真实世界资源批量变成可验证工作环境的流水线。
一句话概括这套思路:智能体的能力上限,取决于它练手的那个环境有多像真的。
四步流水线:从专家蓝图到一条可评分的轨迹
第一步是让专家写「场景蓝图」。不是写提示词,而是把一类工作的骨架讲清楚:最终要交付什么、需要哪些材料、中间必须做哪些判断。比如一位老师写下「测验后归类错题、再针对性地讲解」,换一套试卷和教材,就长出一个新的工作区和一批新任务。蓝图是可复用的,这是规模化的前提。
第二步是去真实世界搬材料。一个采集智能体按蓝图搜索并下载代码仓库、数据集与网页资料,确认确实用得上之后放进工作区,并保留原本的目录结构。这一点看似多余,实际是整个方法的分水岭:真实项目的源码、文档、测试与配置本来就散落在不同层级,保留这种「乱」,才逼得智能体必须自己探索。
第三步是给工作区做「体检」。系统先摸清每个文件是干什么的,再从中抽出一批可以直接核对的具体事实,作为「事实支撑」。任务、参考解法与验收标准都从这些事实推出来,参考解法里的关键数字还要回到工作区复核。
第四步是执行与验收。智能体只能看到工作区和任务说明,要自己翻目录、理关系、拼证据,直到交出成品。验收分两条线:数值对不对、文件有没有生成,交给程序化检查;分析到不到位,交给大模型评委按评分细则打分。打完分,整段操作过程连同分数一起入库,成为训练数据。
1.67 万个工位,复杂到什么程度
这条流水线的产出叫 WorkForge-16K,包含 16665 个可验证工作环境,横跨 40 个专业领域、60 种文件类型。数字听起来抽象,拆到单个环境就很具体:平均每个工作区 42.3 个文件、约 279KB,线索分散在多级目录里;每个任务平均带 21.9 条验证标准;智能体完成一个任务平均要走 31.8 步、调用 33.8 次工具,单条轨迹约 7.6 万 token。
文件类型的分布也很有意思:表格数据占 53.31%,图像占 18.69%,结构化文本占 13.21%,代码占 7.27%,纯文本占 5.58%,音频占 1.26%。这不是为了凑多样性,而是照着真实岗位的输入结构配的——财务要看表、督导要看现场照片、运营要看活动截图、技术要读配置,一份工作往往同时跨越三四种载体。
换个角度理解:7.6 万 token 的轨迹,意味着模型不是在「回答问题」,而是在「干活」。它要先花几万 token 搞清楚这个工作区里有什么,再花几万 token 验证自己的判断,最后才是写结论。对企业来说,这部分成本过去是隐性的,现在被明确摆到了台面上。
40 个专业领域的覆盖也值得说一句。领域多不只是为了好看,而是为了让模型学会「换一套材料照样能干」——医疗看病例与检验单、法律看合同与判例、工程看图纸与验收记录、人力看考勤与绩效表。跨领域迁移的能力,来自不同领域共享同一套工作方法:先摸清材料,再交叉核对,最后交付。这也是为什么同一批环境训出来的模型,能在完全没见过的任务上保持水准。
一个能交付的智能体,八成算力花在「找」和「核」上,只有两成花在「写」上。
真实与合成,差的不是 5.4 倍文件,是「证据密度」
研究团队做了一个对照实验:同一批专家蓝图,一组用真实资源搭工作区,另一组让模型凭空合成。结果是真实工作区的文件数是合成工作区的 5.4 倍,文件类型是 2.4 倍,平均体积从 21.5KB 涨到 279KB。真正致命的不是数量差,而是分布差——合成工作区被「过度整理」过,关键信息集中在少数几个文件里;真实工作区的证据则摊在整个目录树上,找不全就做不对。
论文里给了一个金融领域的例子:智能体扮演量化策略师,基于因子数据库评估各地区因子溢价,最后要交一份 PPT 简报、一份 Excel 分析表和一份清洗后的 CSV。工作区里有 297 个 CSV,分布在 16 个目录中,坑一个不少:月度数据和年度数据混排、缺失值用 -99.99 标记、同一个因子在不同文件里叫不同名字。
这类任务没有标准答案可背,只能靠一步步核对。也正是在这种环境里,「会不会用工具」退居其次,「知不知道该怀疑哪个数字」成了分水岭。
82.4 分超过了谁,12.4% 又说明了什么
成绩单要拆开读。WorkForge-A3B 在 GDPval 上从 45.5 提升到 73.6,在 APEX-Agents 上从 5.0 提升到 21.3,最严的 Agents’ Last Exam 通过率是 12.4%,而此前的专用方案只有 2.9%。WorkForge-27B 则在五个基准上全面提升,GDPval 拿到 82.4,超过了总参数量约 15 倍的 397B-A17B(79.7)。
但同一张表里也写着差距:Claude Opus 4.8 是 89.1,GPT-5.6 Sol 是 90.1。更值得警惕的是 ALE 那 12.4%——这是一个要求智能体长时间自主解决问题、中途不能靠人提示的基准。换句话说,在「有明确交付物、有验收标准」的任务上,环境训练带来的提升非常实在;一旦任务开放、需要自己定义什么算完成,能力就掉得厉害。
这对企业的直接含义是:别把「能自动生成周报」当成「能接手经营分析」。前者是模板填空,后者要自己判断哪些异常值得追、追到哪一层算够。
论文还专门验证了规模与轨迹长度的作用:训练轨迹从 1000 条增加到 16000 条,模型在 ALE 和 WildClaw 上分别提高 13.0 和 8.4 分;同样只用 1000 条数据,用 41 至 60 轮长轨迹训练出来的模型,比用 20 轮以内短轨迹的模型在两个基准上分别高出 4.2 和 5.0 分。结论很朴素——数据要多,过程要长。只让模型看「输入和答案」,不给它看「中间怎么找、怎么错、怎么改」,等于白练。
训练改的是姿势:失败之后先诊断,而不是重试
论文里有一组比分数更有意思的行为数据。经过环境训练的 WorkForge-27B,在 GDPval 的每个任务中平均访问 6.52 个外部网站域名,是基座模型的 5.3 倍;在工作区内定向检索证据的调用占比,从 5.9% 提升到 16.2%。它开始主动去找信息,而不是等着上下文喂到嘴边。
更关键的是失败之后的表现。工具调用失败时,模型的推理长度从 144 个字符增加到 614 个字符——它不再急着换个参数重试,而是先判断刚才为什么失败、要不要换一条路径。这个变化落到业务上,就是从「反复点同一个按钮」变成「停下来想想是不是权限没开」。
交付质量的细项也能对上:五类评分标准的通过率提升了 4.5 到 13 个百分点,其中视觉排版提升 13 个百分点、数值准确性提升 8.2 个百分点。这两项恰恰最依赖充分的调查与细致的核对,而不是语言能力。
对企业最扎心的一条提醒:你有没有「可验证的事实」
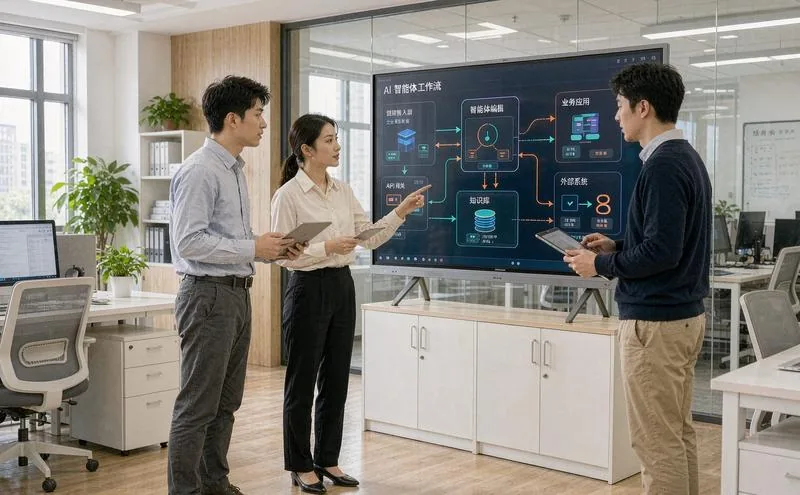
这套方法有一个容易被忽略的前提:工作区里必须存在可以被核对的事实。程序化检查要能读到确定的数字,语义评分要能对着确定的材料判断,任务才有标准答案。如果一家企业的关键数据还停在纸质单据、聊天记录和某个人的脑子里,那么再强的模型也无法被「验证」,只能被「相信」。
这正好解释了为什么同样接了 AI,有的公司觉得好用、有的公司觉得是玩具。差别不在模型,而在底座:订单在系统里、库存有批次、工时有打卡、费用有单据,AI 才有东西可查;反过来,口径一年改三次、同一张报表两个版本,模型越努力,错得越快。
WorkForge 的做法其实给了一条反向路径:先定义「什么算做对了」,再倒推需要哪些材料、哪些字段、哪些权限。这套顺序,和企业上管理系统的顺序是同一件事——先把流程结构化,再谈智能化。
AI 同事接不了手,通常不是因为它不够聪明,而是因为这间办公室里没有第二个能核对的人。
想用上这套思路,先做三件不花钱的事
第一件,挑一个「有唯一答案」的任务做试点。月结对账、门店日报汇总、库存差异核查、报销单据复核,这些任务的特点是结果可以被验证:数字对不对、单据全不全、差异能不能解释。用它们来检验 AI,比让它写营销文案有意义得多。
第二件,把验收标准写下来。不是写「分析要专业」,而是写「毛利率按含税口径、与上月差异超过 2 个百分点必须列出原因、原因必须能追到具体单据」。WorkForge 每个任务平均 21.9 条验证标准,这个密度值得参考——标准越具体,模型越知道往哪儿使劲。
第三件,治理目录与权限。文件在哪、谁负责、哪个版本是准的,这三件事不解决,任何智能体进场都会先陷进「找文件」。文档管理、协同办公、数据分析这类系统看起来不性感,但它们决定了你的企业有没有资格谈「AI 同事」。
顺带说一个容易忽略的细节:论文对比了三种验收方式,只用程序化检查得 14.89 分、只用语义评分得 15.62 分,两者结合能到 22.11 分。这对企业的启发是,验收不能只有一条腿——数字对不对要靠规则校验,分析有没有说服力要靠人复看。把这两件事都设计进流程,模型才知道「做对」到底意味着什么。
把趋势落成系统
文中反复强调的前提——数据在线化、流程结构化——正是下面这些系统在解决的事
常见问题
不是。它是一套构建可验证工作环境的方法与数据集,面向的是训练工作智能体的团队。企业真正能借鉴的是它的方法论:先定义交付物与验收标准,再准备真实材料,最后才谈模型。把这三步做扎实,哪怕用的是通用模型,效果也会明显不同。
看懂了趋势,下一步是选对系统
告诉我们你的行业、团队规模和最想自动化的环节,我们从 406 条产品线里帮你匹配合适的管理系统, 或按需求定制开发——并为 AI 接入预留好规范的数据接口。
7×24小时在线
把文章里的思路,落成你的系统方案
留下行业与业务规模,我们免费给出针对性的选型建议与实施路径
服务保障
- 免费需求分析
- 按行业匹配系统
- 实施方案透明
- 7×24 技术支持