
8160亿参数模型搬进两台桌面主机:Meta 开放权重,大模型私有化第一次有了「桌面级」选项
美东时间 10 月 15 日,Meta 开放旗舰模型 Muse Spark Open 的权重:总参数 8160 亿、每 token 激活约 420 亿、上下文窗口 100 万词元,经 MLX 优化后可由两台 M5 Ultra Mac Studio 本地承载,Meta 官方称其为「迄今能力最强的美国开放权重模型」,而能力更强的 Muse Wonder 系列仍保持闭源。开放权重落地前要算清许可、硬件、运维三笔账,本文逐笔帮你算。
要点速览
美东时间 10 月 15 日,Meta 发布开放权重模型 Muse Spark Open:总参数 8160 亿、每 token 激活约 420 亿,原生支持文本、图像、视频与音频输入,上下文窗口 100 万词元,主打编程与智能体任务,官方称其为迄今能力最强的美国开放权重模型
Meta 自报的对比测试中,该模型在工作流程、工具调用、知识推理、知识可靠性、复杂视觉推理、图像事实问答 6 项测试排名第一;Artificial Analysis 智能指数报 39 分,同批数据显示软件开发等任务上 Kimi、千问、智谱等中国开源模型仍更胜一筹
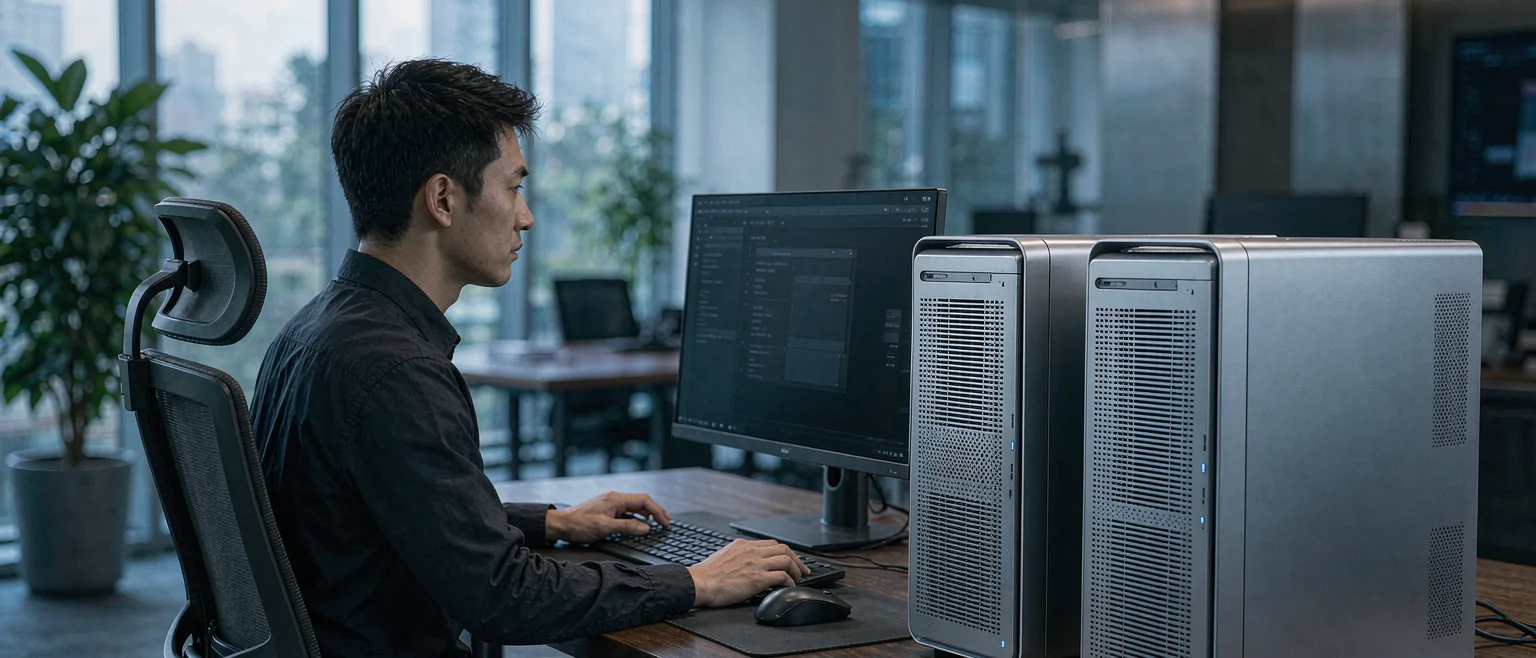
与苹果合作的本地化方案同步落地:借助最新版 MLX 框架与 M5 Ultra 统一内存架构(每台 Mac Studio 最高 512GB),两台 Mac Studio 即可完整承载 NVFP4 量化版本,两台机器经雷电 5 直连后如同一台拥有约 1TB 统一内存的桌面级推理平台
权重以 Muse Model License 发布,附带有限商业条款,许多开发者可免费使用;但能力更强的 Muse Wonder 系列保持闭源——Meta 开放的是次旗舰,守住的是前沿
冷静看待:本地化形态变小不等于预算变小,BF16 版本仍需约 2TB 显存、NVFP4 版本也需约 700GB 显存的服务器级配置;开放权重落地还要过许可条款、硬件投入与运维能力三道门槛
这一局棋上的三个玩家
开放次旗舰、闭源真旗舰、中国开源阵营紧咬
Muse Spark Open
Meta · 把开放权重的上限拉到旗舰级
- 8160 亿总参数、每 token 激活约 420 亿,上下文窗口 100 万词元
- Meta 自报 6 项测试第一,Artificial Analysis 智能指数 39 分
- MLX 优化后两台 M5 Ultra Mac Studio 可本地运行 NVFP4 版本
Muse Wonder 系列
Meta · 留在手里的闭源真旗舰
- 本周一先行发布,官方承认能力高于 Muse Spark Open
- 不开放权重,仅通过云端服务调用
- 开放次旗舰、闭源前沿的双轨策略,兼顾开发者生态与商业化
中国开源阵营
月之暗面、阿里、智谱 · 软件开发等任务上仍占优的紧咬者
- Meta 自报对比中,Kimi K3、Qwen3.8、GLM 5.3 在软件开发等任务上仍领先
- 近期密集开源迭代,部署工具链与社区生态成熟
- 中文场景适配与性价比是国内企业的现实选项
一周之内:闭源旗舰与开放次旗舰先后落地
Meta 的双轨策略在一周内走完
- 2026 年 10 月 13 日
Meta 先行发布闭源旗舰 Muse Wonder 系列,此前上一轮开放模型生态未达预期后,扎克伯格重组 AI 研发体系、转向打造能力更强的闭源模型的路线被公开确认
- 2026 年 10 月 15 日
Meta 发布开放权重模型 Muse Spark Open 并同步公开权重,称其为迄今能力最强的美国开放权重模型,主打长周期智能体任务、复杂软件工程与多步推理
- 2026 年 10 月 15 日
与苹果合作的本地化方案公布:最新版 MLX 针对 M5 Ultra Mac Studio 优化,两台 512GB 统一内存机型可完整承载 NVFP4 量化版本,权重可从 Hugging Face 直接拉取
- 2026 年 10 月
模型同步登陆 Baseten、Fireworks AI、Groq、Modal、Nebius、OpenRouter、Together AI 等推理平台,权重可在 Hugging Face、亚马逊 SageMaker AI、谷歌云 Model Garden、微软 Foundry Models 等渠道下载
两台桌面主机,第一次装下旗舰级开放权重
美东时间 10 月 15 日,Meta 发布开放权重模型 Muse Spark Open 并同步公开权重下载。这是一款原生多模态模型,总参数量 8160 亿,采用混合专家架构,每个词元实际激活约 420 亿参数,支持文本、图像、视频和音频输入,上下文窗口达到 100 万词元。Meta 将其定位为编程与智能体专用模型,官方称其在长周期任务、复杂软件工程和多步骤推理上表现出色,并直接给出定性判断:这是迄今能力最强的美国开放权重模型。
比参数更有戏剧性的是它的运行形态。借助最新版 MLX 框架(苹果针对自家芯片优化的开源机器学习框架),Muse Spark Open 被针对配备 M5 Ultra 芯片的 Mac Studio 做了本地化优化。苹果的统一内存架构让 M5 Ultra 的集成显卡最高可用 512GB 内存,两台 Mac Studio 合计约 1TB,刚好装下 NVFP4 量化后的完整模型;芯片 1.2TB/s 的内存带宽足以支撑推理读取。两台机器通过雷电 5 直连,权重不移动,只有微秒级的中间结果在两台机器之间往返——Meta 的描述是「两台 Mac Studio 表现得像一台拥有 1TB 统一内存的超级计算机」。
为什么这件事值得非技术岗位的管理者关注?因为变的不是跑分,而是形态。过去要跑一个旗舰级模型,你需要进机房、上机柜、走采购流程;现在它被装进了两张办公桌就能放下的设备里。Meta 用 Muse Code 在本地完成了真实演示:为一个开源客户端修复缺陷、开发新功能并完成完整构建,还全程本地驱动视频剪辑软件逐帧检查素材、自动挑出最佳片段并裁成竖版。模型第一次以「桌面设备」的形态,完成了过去要云端集群才能干的活。
Meta 的算盘:开放次旗舰,闭源真旗舰
把时间线拉长看,这次发布是一盘双轨棋。本周一,Meta 先行发布了能力更强的闭源旗舰 Muse Wonder 系列;三天后的周四,再开放次旗舰 Muse Spark Open 的权重。一闭一开之间,Meta 的战略意图相当清楚:闭源模型保住商业化的溢价能力,开放模型换取开发者生态的站队。Meta 首席 AI 官在公开表态中也把原则说透了——原则上不对最强性能的模型开源,但会持续向开发者社区开放性能稍低的版本。
这个策略有前情。Meta 曾凭 Llama 系列推动开放模型生态,但上一轮模型竞争中表现未达预期,扎克伯格随后重组 AI 研发体系、转向闭源路线。此次重新开放权重,是在「扩大开发者生态」与「保留前沿技术优势」之间重新找平衡。对观望的企业来说,这传递了一个重要信号:头部厂商的开放与封闭是随时会摆动的战略选择,不是永久承诺。
落到条款上更要清醒。Muse Spark Open 以 Muse Model License 发布,附带有限商业条款——官方表述是「允许许多开发者免费使用」,但免费不等于无约束,用户量门槛、部署方式、能否作为服务转售,都需要逐条核对。这次发布里还有一段耐人寻味的合作:苹果与 Meta 在隐私政策、平台规则上积怨多年,如今却共同推动开放权重模型在苹果硬件上落地。商业世界没有永远的敌人,只有永远的利益——对模型供应商的「开放」,也应作同样的理解。
「数据不出门」的诉求,第一次有了桌面级答案
先说企业为什么想本地跑模型。客服记录里有个人的手机号和地址,合同库里躺着报价与账期,财务系统存着成本与利润,生产数据牵涉工艺机密——这些数据一旦经由第三方云端 API 处理,就涉及出域授权、供应商信任与合规审查三重问题。医疗、法律、金融、政务等行业还有明确的监管红线。「数据不出门」不是技术洁癖,是很多行业的真实约束。
过去这道门太贵了。Muse Spark Open 的 BF16 版本需要约 2TB 显存,即便是 NVFP4 量化版本也需要约 700GB 显存,相当于一整台八卡高端服务器的配置;单台设备的采购预算就把绝大多数中小企业挡在门外。量化压缩加统一内存架构把形态做小,是这次发布真正值得记住的工程进展——虽然两台 Mac Studio 依然价格不菲,但「两张办公桌 + 墙上插座」的部署形态,第一次与「旗舰级开放权重」出现在同一个句子里。
但必须泼一盆冷水:形态变小不等于预算变小。桌面级方案针对的是个人开发者与小团队的试验场景,吞吐量、并发能力与可用性都和生产级云服务有差距;企业若要认真做私有化,服务器级 GPU 方案仍然是主流路径,几十万元级的起步预算并没有因为这次发布消失。形态变小的真实意义,是采购与运维的决策门槛下降了——企业可以先用桌面级设备做技术验证,再决定要不要上生产环境,试错成本比过去低了一个量级。
落地前算清三笔账:许可、硬件、运维
第一笔是许可账。开放权重模型的许可条款是商务条款,不是技术文档。Muse Model License 的「有限商业条款」具体限什么:是否按用户量或收入划线、是否允许将模型能力包装成对外服务、二开后的衍生模型如何授权,每一个问题都可能直接影响商业模式。把许可审查嵌入采购流程,和审合同一样逐条过,是这一轮 AI 采购的新常态。
第二笔是硬件账。本地部署的成本结构是「一次重投入 + 持续电费与维护」,云端 API 的成本结构是「按用量付费」。参照同周开源的国产模型价格——每百万词元约 0.19 美元——大多数企业的年度调用量折算下来,API 成本远低于自建的硬件摊销加人力成本。只有当调用量大到 API 账单逼近硬件方案、或者数据红线完全不容妥协时,自建才在财务上成立。建议用一个简单的判断式:把近三个月的真实调用量乘以单价,再与「硬件五年摊销 + 电力带宽 + 专职人力」比较,让数字做决定。
第三笔是运维账,也是最容易被低估的一笔。模型会迭代、量化版本会更新、推理框架会升级,安全补丁要有人跟进,故障要有预案。自建方案的真实成本里,人力往往占大头——一个能管住模型服务的工程师,年薪远高于几台设备的电费。没有专职 IT 团队的企业选择自建,相当于买了一辆车却没有司机:车是好车,只是开不动。
榜单之外:中国开源模型仍守着几座山头
Meta 自报的测试成绩确实亮眼:与市场上的前沿开源模型对比,Muse Spark Open 在工作流程、工具调用、知识推理、知识可靠性,以及复杂视觉推理和图像事实问答这 6 项测试中排名第一。但同一批数据里还有另一半信息:在软件开发及其他某些任务上,Kimi、千问、智谱等中国开源模型依然更胜一筹。一份由厂商自己发布的对比,两种结论同时成立——这才是读榜单的正确姿势。
怎么看自报成绩?三点建议。第一,注意评测条件:Meta 的成绩是在 xhigh 推理档位下测得的,档位不同、成绩不同;第二,注意评测集:每家厂商选的对比集不同,同一模型在不同榜单上的名次可能差出好几名,Artificial Analysis 智能指数 39 分只是一个综合参考;第三,注意版本时效:开源模型社区迭代极快,今天的第一未必守得到下个季度。榜单当地图,不当目的地。
对国内企业还有一个更现实的维度:中文场景。合同里的行业术语、客服对话里的口语表达、报表里的中国式科目名称,都是中文模型的主场。国产开源模型在中文语料、行业适配、合规审查上的积累,加上成熟的量化版本与社区工具链,让它们在多数国内企业场景里仍是第一优先级的候选。选型的正确顺序是:先用自己整理的 50 到 100 条真实业务样本跑一遍候选模型,再看榜单——而不是反过来。
什么样的企业适合本地跑模型,什么样的不适合
三类企业适合认真评估本地化。第一类是数据强敏感行业:医疗、法律、金融、政务,数据出域的合规成本高到足以覆盖自建投入;第二类是调用量足够大的企业:API 账单按年累加已经逼近或超过硬件方案的摊销成本,规模效应开始站在自建一边;第三类是有 IT 团队的企业:有人接得住部署、监控、升级与故障处理,运维账算得平。三类缺一,就要谨慎。
反过来说,不适合的信号也很清晰:没有专职 IT 人员、数据谈不上敏感、调用量按天算只有几千次。这类企业上本地部署,省下的是 API 费用,赔上的是硬件折旧与人力——账怎么算都是亏的。更合理的路径是把预算花在业务系统的在线化上:客户、订单、库存、流程先结构化地进系统,模型能力通过 API 接入业务系统来兑现。
多数企业真正合适的形态是中间态——混合架构。敏感数据的场景交给本地或私有化模型处理,通用任务走云端 API,业务系统在中间做路由与权限控制:什么数据可以出域、什么请求走哪条通道、日志如何审计,全部由系统层统一治理。企业内部的使用者感知不到差异,数据红线却始终有据可查。这也是管理系统在 AI 时代的核心价值:模型会换代,系统里的数据治理与权限体系是长期资产。
给中小企业的一条务实路线
第一步不是买机器,而是把数据在线化。这一步听起来朴素,却是所有 AI 叙事的地基:模型再强,读不到结构化的客户、订单、合同数据,就只能泛泛而谈。先让核心业务进系统、口径统一、接口规范,无论将来选择云端 API 还是本地模型,这部分投入都不会浪费——它是业务系统的本分,不随模型换代而贬值。
第二步做小范围验证。选一个内部场景——合同摘要、报表解读、客户来访记录整理都可以——用云端 API 跑四到八周的试点,记录准确率、节省工时和出现的问题。试点的目的不是证明 AI 有多强,而是回答三个问题:这个场景的价值够不够大、错误率能不能被业务接受、流程要不要为它调整。价值被验证之前谈部署形态,是本末倒置。
第三步,如果数据红线与调用量确实指向私有化,优先考虑国产开源模型与成熟工具链。理由很实际:量化版本齐全、社区适配活跃、文档与人才供给充足,遇到问题搜一下就有答案;而单一旗舰模型的私有化,配套生态还需要时间成熟。中小企业的第一台本地模型,大概率不是参数最大的那个,而是社区最活跃的那个——遇到问题时,活跃的社区比漂亮的发布会更能救急。
行动清单
五件事,按顺序做:
- 把「哪些数据不能出域」列成书面清单,这是私有化与云端路线的分界线,也是合规审查的起点
- 统计近三个月模型调用量(或按业务场景预估),乘以每百万词元单价折算年度 API 成本,与自建的「硬件摊销 + 电力带宽 + 专职人力」对比
- 逐条审阅 Muse Model License 等许可条款,重点核对商用限制、用户量门槛与转售条款,必要时让法务出具意见
- 选一个内部场景用云端 API 做四到八周试点,先验证价值再谈部署形态
- 关注国产开源模型的量化版本与社区生态——中小企业的第一台本地模型,大概率不是旗舰,而是社区最活跃的那个
旗舰模型跑进桌面是里程碑,但你的第一台本地模型,大概率是一台装着国产开源模型的普通服务器——先有场景,再谈形态。
把趋势落成系统
文中反复强调的前提——数据在线化、流程结构化——正是下面这些系统在解决的事
常见问题
能承载 NVFP4 版模型并完成真实的编码与智能体任务,这一点 Meta 已用实际演示证明。但桌面级方案的吞吐量、并发能力与可用性和生产级云服务仍有差距,更适合个人开发者与小团队做技术验证;企业生产环境的主力方案,短期内仍是服务器级部署或云端服务。
看懂了趋势,下一步是选对系统
告诉我们你的行业、团队规模和最想自动化的环节,我们从 406 条产品线里帮你匹配合适的管理系统, 或按需求定制开发——并为 AI 接入预留好规范的数据接口。
7×24小时在线
把文章里的思路,落成你的系统方案
留下行业与业务规模,我们免费给出针对性的选型建议与实施路径
服务保障
- 免费需求分析
- 按行业匹配系统
- 实施方案透明
- 7×24 技术支持