
一秒 1068 个词元:Mercury 3 用扩散模型撕开自回归铁幕,实测却只有 254
2026 年 10 月 19 日至 20 日,Inception Labs 发布扩散式大语言模型 Mercury 3:参数量较 Mercury 1 扩大 40 倍以上,上下文从 26 万跳到 100 万词元,官方口径 1068 tok/s、比 GPT-6 Luna 与 Claude Haiku 5.5 快 4 至 8 倍,首发五折后输入 0.10 美元、输出 0.35 美元每百万词元。但第三方当日实测中位数只有约 254 tok/s。本文拆解扩散式语言模型为什么突然有了规模定律,以及企业该怎么读这类「速度发布会」。
要点速览
Inception Labs 发布 Mercury 3:扩散式大语言模型,参数量较 Mercury 1 扩大 40 倍以上,官方称标准基准智能提升约 3 倍而速度未降
上下文窗口从 Mercury 2.5 的 26 万词元直接跳到 100 万词元,官方口径在 NVIDIA GPU 上跑到 1068 tok/s,比 GPT-6 Luna 与 Claude Haiku 5.5 快 4 至 8 倍
官方 12 项对比测试中领先 8 项,SWE-Bench Atlas 得 51.08 分(Luna 33.33、Haiku 5.5 32.26),IFBench 得 76.84 分;长上下文检索 MRCR v2 与长编程 DeepSWE v1 仍是短板
定价每百万词元输入 0.20 美元、输出 0.70 美元,首发五折为 0.10 / 0.35 美元,缓存输入再打一折;新账户赠 1 亿词元,OpenAI 接口兼容,但不开放权重
生产实测留了个诚实的注脚:50 个 Mind2Web 实时网页导航任务只完成一半,官方称在同等词元量与步数下仍显著优于 GPT-6.1-Sol;Octen AI 端到端中位数 2.2 秒
第三方同日实测给了一盆冷水:某 OpenRouter 供应商实测中位数约 254 tok/s、P50 延迟 1.91 秒,与官方 1068 相差四倍以上——厂商口径与自家网关口径不是同一个数字
这次发布里的三个关键数字
1068、100 万、0.10 美元——速度、记忆、价格
1068 tok/s
Inception 官方口径 · 速度 · 把「等它写完」从体验里拿掉
- 官方称在 NVIDIA GPU 上达到每秒 1068 个词元,比同为速度取向的 GPT-6 Luna、Claude Haiku 5.5 快 4 至 8 倍
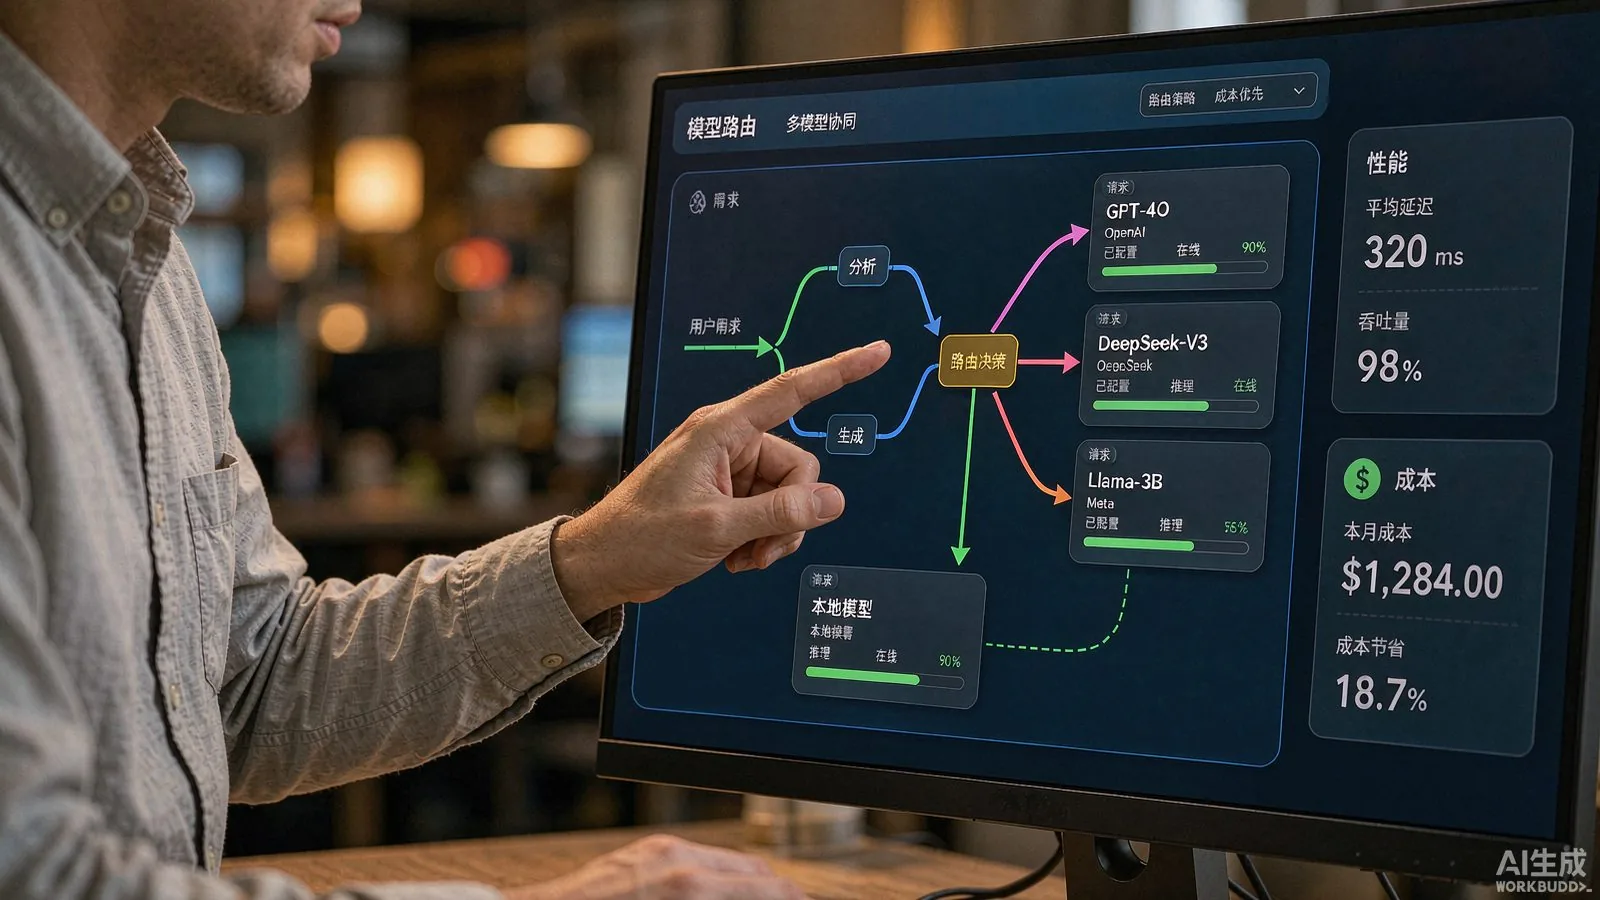
- 同批发布 Mercury Voice,面向语音场景优化首词元时间,官方口径低于 170 毫秒
- 第三方实测中位数约 254 tok/s,选型时以自己的网关实测为准
100 万词元上下文
记忆长度 · 一次性可读 · 从 26 万直接跳到 100 万
- 上下文窗口从 Mercury 2.5 的 26 万词元提升到 100 万词元,约合七百多页中文材料
- 官方同时提示:长上下文检索 MRCR v2 得分 75.50,仍落后 Haiku 5.5 的 78.40
- 长文档场景建议先用真实材料做抽检,不要按窗口上限规划容量
0.10 / 0.35 美元
首发五折 · 每百万词元 · 按量计费的那一档被再压一档
- 原价输入 0.20 美元、输出 0.70 美元每百万词元,首发五折至 0.10 / 0.35 美元
- 缓存输入在折扣基础上再减九成,长系统提示与固定知识反复调用时优势明显
- 新账户赠送 1 亿词元用于压测,企业版另加专用容量、自动扩缩与数据留存配置
扩散式语言模型的这几年
从「小得快」到「又快又大」,这条支线走了不到两年
- 2025 年 6 月
Inception 发布 Mercury 1,扩散式语言模型第一次证明「并行去噪也能写文本」,但体量停留在验证阶段
- 2026 上半年
Mercury 2.5 把上下文推到 26 万词元,速度优势延续,能力仍被质疑追不上自回归主流
- 2026 年 10 月 19 日
Mercury 3 发布:参数量超 Mercury 1 的 40 倍,上下文 100 万词元,官方 1068 tok/s,同步发布 Mercury Voice 与 Mercury Decide
- 2026 年 10 月 20 日
MarkTechPost 等媒体跟进报道,首发五折定价与 12 项对比成绩单公布,API 上线 Inception、OpenRouter、Baseten、Vercel
- 2026 年 10 月 21 日
第三方交叉实测引发讨论:同一模型在公开网关上实测中位数约 254 tok/s,「厂商口径 vs 你的口径」成为选型新议题
自回归的十年铁幕:一个字一个字写,决定了所有等待
过去十年,几乎所有主流大语言模型都遵循同一套工作方式:自回归。模型读完你的问题,然后一个词元一个词元地往下写,每写一个都要等前一个写完。这个机制简单、稳定、效果极佳,也直接决定了我们使用 AI 的全部体感——你会看到文字像打字机一样一行行冒出来,长答案要等十几秒,长流程要等几分钟。
这条铁幕的代价在消费级聊天里不痛不痒,在企业场景里却被放大成产品缺陷。一个语音客服,用户说完话要等两秒才听到回应,体验就已经崩了;一个网页智能体,每一步都要调用模型,二十步累积下来用户等的就是两分钟;一个批量处理任务,几万条数据排队等生成,瓶颈从来不是显卡不够,而是生成本身太慢。
行业这些年给出的解法主要有两条:把模型做小做快(Flash 段位的逻辑),或者把上下文和缓存做极致(降低重复计算)。两条都是在自回归的框架内做优化,天花板始终在那儿——只要还是一个一个写,吞吐就有上限。Mercury 3 想做的是第三条路:换掉写法本身。
扩散式语言模型:先把整篇答案画出来,再一起擦干净
扩散模型在图像领域已经家喻户晓:先给一张纯噪声,再一步步去噪,最后得到清晰图片。把同样的思路搬到文本上,做法是:模型先对整段答案给出一个粗糙的整体草稿,然后在若干轮迭代里同时打磨所有位置——不是从左到右,而是整段一起改。
这个差别带来的直接结果是并行度。自回归模型生成 500 个词元要串行走 500 步;扩散模型可以在远少于 500 次的并行前向传播里完成同样的长度。串行步数少了,等待就少了,吞吐上限自然被抬高。
当然天下没有免费的午餐。扩散式文本生成长期被质疑的点在于质量:一次改写整段,如何让局部细节和全局逻辑都对?这也是过去两年扩散语言模型一直停留在「小得快」验证阶段的原因——一旦把参数堆上去,质量往往跟不上同体量的自回归模型。Inception 这次要证明的,恰恰是这个质疑已经过期。
1068 tok/s 与 40 倍参数:这次的赌注是「规模定律也适用于扩散」
Mercury 3 的核心叙事只有一句:扩散式模型也能吃规模定律。官方给出的数据链条是——参数量比 2025 年 6 月发布的 Mercury 1 扩大 40 倍以上,标准基准上的智能水平相比 Mercury 1 mini 提升约 3 倍,而推理速度仍然保持在每秒 1000 个词元以上。
如果这句话成立,它的意义远超一次产品发布。过去几年整个行业的投入逻辑都建立在「参数堆上去、数据喂进去、能力就涨」这条经验曲线上,而这条曲线此前只在自回归架构上被反复验证。扩散式模型如果能复制同一条曲线,行业就多了一条独立于自回归的扩张路径:能力可以继续涨,而推理不会跟着变慢。
需要保持清醒的是,这个结论目前由厂商自证。Inception 没有公开 Mercury 3 的具体参数量,也没有公开权重,所有对比都跑在厂商设定的中等档位上。第三方独立复现还没有出现——这不是否定,只是说明它现在是一个值得验证的假设,而不是一条已经写进教科书的定律。
12 项基准赢 8 项:赢在哪,输在哪
把官方公布的成绩单摊开看,Mercury 3 的优势分布相当清晰。在 12 项与 GPT-6 Luna、Claude Haiku 5.5 的对比中,它领先 8 项,赢面最大的两项是 SWE-Bench Atlas(51.08 分,对 Luna 的 33.33 分、Haiku 5.5 的 32.26 分)和 IFBench(76.84 分,领先 Luna 约 15 分)。前者是智能体编程,后者是指令遵循——两项都指向「按指令把事做对」这个维度。
输的几项同样有信息量:DeepSWE v1 得 46.31 分,落后 Haiku 5.5 的 51.62 分;长上下文检索 MRCR v2 得 75.50 分,落后 78.40 分;在 AA-Omniscience-Public 与 AA-LCR v1.1 两项上,Luna 也略占上风。合起来看,它的短板集中在长链条编程与长上下文精确检索。
这个强弱分布其实很诚实:扩散式架构一次并行处理整段,擅长的是「整体生成快、局部指令跟得紧」,不擅长的是「沿着一条长链一步步推到底」。对企业的直接启示是——别拿它去做需要逐步推理的长链路任务,把它放到高频、短交互、要求即时反馈的位置上,才是扬长避短。
生产实测:50 个网页导航任务只完成一半,为什么还算赢
这是本次发布里最值得称道的一段:Inception 没有只贴好看的分数,而是公布了一个不太好看的实测。在自家生产网页智能体框架里跑 50 个 Mind2Web 实时导航任务,Mercury 3 只完成了 50%——一半的任务失败了。
但官方紧接着给出了对照:在相同的词元用量、相同的智能体步数下,这个成绩显著优于 GPT-6.1-Sol,而单次词元成本只是后者的一小部分。换句话说,速度的红利不是换来更高的单次成功率,而是换来「同样的时间与预算可以多试几次」——在智能体场景里,多次尝试本身就是成功率的一部分。
客户侧的证词也集中在延迟这个维度。做智能眼镜搜索的 Octen AI 报告:搜索环节本身约 80 毫秒,瓶颈全在生成;换用 Mercury 3 后,生成中位数 0.9 秒,端到端响应中位数 2.2 秒。做实时辅导的 RevisionDojo 报告提示、答案与定义都在一秒左右返回,直接平替了原有方案。面向受监管行业做客服智能体的 Lorikeet 则称,Mercury 3 在早期测试里延迟最低,同时评测与生产表现更好。
254 vs 1068:官方数字和你自家网关的数字,差的那一截在哪
发布当天,第三方评测站 explainx 做了一次交叉实测:在某个 OpenRouter 供应商上,Mercury 3 的实测中位数约为每秒 254 个词元,P50 延迟 1.91 秒——只有官方口径 1068 的四分之一左右。这个落差不是谁在说谎,而是两套测量口径的必然差异。
官方数字通常是理想条件下的峰值:特定的 GPU 型号、特定的并发、特定的输入输出长度比、厂商自己的服务栈。而你在自己的网关上拿到的是另一组条件的叠加——供应商的调度策略、排队情况、你的提示词长度、输出长度、并发压力。任何一环不同,数字就不是同一个数字。
这件事给所有做技术选型的人提了个醒:厂商公布的速度是「该架构的上限证明」,不是「你明天的生产指标」。正确的做法是把厂商数字当作筛选条件而不是决策依据——它告诉你这个模型值得测;真正决定要不要用的,是你拿着自己真实的提示词、真实的并发、真实的输出长度,在自己的链路上跑出来的那组数。建议上线前固定一组 50 到 100 条真实样本,在候选模型上各跑三遍,取中位数。
价格与开放策略:五折首发、不开权重,这笔账怎么算
定价上,Mercury 3 的原价是每百万词元输入 0.20 美元、输出 0.70 美元,首发期五折到 0.10 / 0.35 美元,缓存输入在此基础上再减九成。新账户赠送 1 亿词元,企业版另提供专用容量、自动扩缩、合规控制与可配置的数据留存。接口遵循 OpenAI 格式,现有代码基本不用改,渠道覆盖 Inception 官方 API、OpenRouter、Baseten 与 Vercel。
开放策略上则相当克制:不公开参数量,不放出权重,纯 API 交付。这和国内厂商近两年「API 先行、权重随后」的路线明显不同,也决定了它服务的客群——不要求数据不出内网的业务。对金融、医疗、政务这类有硬合规约束的国内客户,短期它不是候选;对出海业务、面向 C 端的实时产品,接口兼容加低延迟的组合很实用。
还有一点容易被忽略:交付形态决定了议价权。纯 API 意味着你的成本曲线掌握在别人手里,五折期结束后的价格、未来的涨价节奏都不由你决定。做过成本模型的人都懂,这种不确定性要提前折进预算——要么在架构上保持多模型可切换,要么在合同里锁定周期价格。
对企业意味着什么:延迟是体验的分水岭,不是参数表上的一行
把这场发布翻译成企业语言,核心只有一句:AI 的可用性正在从「能力够不够」转向「响应等不等得起」。三年前企业问的是「它能不能答对」,现在越来越多场景问的是「用户愿不愿意等它对」。在语音、客服、实时推荐、表单填写辅助这类场景里,一秒和三秒之间隔着的不是体验差异,是用户留不留下来。
但速度不该是选型的唯一维度。这次发布同时给出了正反两方面的示范:厂商敢公布只完成一半的实测,第三方敢贴出与官方差四倍的实测,这两件事加在一起,才是健康的技术市场——有承诺,也有校验。企业要学的正是这种双口径习惯。
- 第一步,先分类:把你的 AI 场景按「是否对延迟敏感」分成两类。语音、在线客服、实时辅助、批量生成属于敏感型;离线报告、夜间批处理、长文档分析属于不敏感型——后者用更便宜的常规模型即可,不必为速度付费
- 第二步,定指标:给敏感型场景设一个可验收的延迟指标(如首字 800 毫秒、端到端 2.5 秒),写进需求而不是写进愿望,作为验收与选型的硬门槛
- 第三步,自实测:固定 50 至 100 条真实样本,在候选模型上各跑三遍取中位数,用自己的提示词长度与并发量测,不采信任何厂商峰值数字
- 第四步,做路由:把速度与成本分层,低难度高频请求走快模型,高难度低频请求走强模型,用统一网关屏蔽差异——模型半年一换,业务代码不动
- 第五步,留退路:架构上保证换模型只改配置不改业务,避免被单一厂商的定价与政策锁定;同时把每次换模型的效果回归做成固定流程
速度竞赛的真正意义,不是让 AI 变得更厉害,而是让「用户等得起」这件事第一次不再需要用能力和预算去换。
把趋势落成系统
文中反复强调的前提——数据在线化、流程结构化——正是下面这些系统在解决的事
常见问题
看任务对延迟的敏感度与推理链长度。扩散模型擅长高频、短交互、要求即时反馈的场景(语音应答、在线客服、表单辅助、实时辅导),一次并行生成整段,速度快;但在长链条逐步推理、长上下文精确检索上目前仍弱于同档自回归模型(Mercury 3 在 DeepSWE v1 与 MRCR v2 上就落后 Haiku 5.5)。稳妥做法是分场景路由,而不是全体切换。
看懂了趋势,下一步是选对系统
告诉我们你的行业、团队规模和最想自动化的环节,我们从 406 条产品线里帮你匹配合适的管理系统, 或按需求定制开发——并为 AI 接入预留好规范的数据接口。
7×24小时在线
把文章里的思路,落成你的系统方案
留下行业与业务规模,我们免费给出针对性的选型建议与实施路径
服务保障
- 免费需求分析
- 按行业匹配系统
- 实施方案透明
- 7×24 技术支持