
不碰权重也能变强:谷歌把智能体的「外挂」拆成八个可改零件,让模型自己修自己
谷歌 Cloud AI Research 开源 Apache-2.0 框架 Harness²:冻结模型权重,只优化系统提示词、护栏、记忆、工具指导、子智能体、技能、脚本、插件八个组件;任务级用「提议—探测—组合」递归,跨任务把经验蒸馏成下一次的起点。在 WorkBuddy-Bench 提升 11.5 分、JobBench 4.5 分、LAB 11.8 个百分点。本文讲清它怎么工作、企业怎么用,以及三个必须避开的坑。
- 可编辑的 harness 组件
- 8 个
- WorkBuddy-Bench 单步优化提升
- +11.5 分
- LAB 准确率提升
- +11.8 pp
- GitHub Star(第三方索引站,10-27)
- 19.6k
要点速览
Harness² 由谷歌 Cloud AI Research 开源,Apache-2.0 许可,模型权重全程冻结,只改模型外围的执行装备。
八个可编辑组件:系统提示词、护栏、记忆、工具指导、子智能体、技能、脚本、插件。
第一层是任务级递归:PPC(提议—探测—组合),先提多个改法,再逐个试跑对比,最后合并最优。
第二层是 harness 级递归:把一次成功的改法与执行轨迹蒸馏成经验文件,下次任务先检索再改。
支持并行与顺序两种递归;执行器为 OpenCode 与 Codex,本地 demo 不需要模型凭据。
在权重冻结、不使用标准答案、只做单步优化的条件下:WorkBuddy-Bench +11.5 分、JobBench +4.5 分、LAB +11.8 个百分点。
测试模型包括 Gemini 3.5 Flash 与 GLM-5,说明增益来自 harness,而不是某一个特定模型。
代价是「探测成本」:每一个候选改法都要真跑一遍,它省的是微调,不是推理。
三个对象:框架、模型与另一条路线
同一个实验里,模型是固定的,被优化的是模型外面那层装备
Harness²
Google Cloud AI Research · 不改权重,改装备
- Apache-2.0 开源许可
- 八个可编辑组件
- PPC + 经验蒸馏两层递归
- OpenCode / Codex 执行器
Gemini 3.5 Flash
Google · 参与实验的模型之一
- 权重冻结,不参与训练
- 单步优化即获得基准提升
- 与 GLM-5 对照,排除单一模型偶然性
GLM-5
智谱 · 另一款参与实验的模型
- 同一套 harness 优化流程
- 用于验证方法可迁移
- 不依赖特定厂商的模型接口
从概念到开源:harness 这条线的时间点
它解决的不是「模型会不会」,而是「模型用得顺不顺」
- 2025 年
harness(智能体外围装备)从提示词工程里独立出来,成为 Agent 工程的单独议题
- 2026 年 10 月
谷歌 Cloud AI Research 在 arXiv 公开 Harness² 论文(2610.14224),同步开源代码
- 2026 年 10 月 25 日
中文媒体跟进报道,核心表述是「权重不动,装备自改」
- 2026 年 10 月 27 日
第三方项目索引站显示 GitHub 关注度约 19.6k,社区开始复现论文结果
- 持续
Apache-2.0 许可,支持 OpenCode 与 Codex 执行器,内置 JobBench、LAB、WorkBuddy-Bench 三套评测
一个被忽略的事实:智能体一半的强弱,不在模型里
过去一年,企业评估智能体的方式几乎没有变过:先看榜单,再看参数,最后比价格。但真正把智能体放进业务的人会发现,同一个模型,换一套工具描述、换一种记忆组织方式、换一个子任务拆分策略,完成率能差出十几个百分点。差距不在权重里,在权重外面的那层「装备」里。
这层装备在英文里叫 harness,直译是「挽具」——套在模型外面、帮它与真实世界交互的一切:提示词、工具说明、记忆、护栏、子智能体、脚本、插件。谷歌 Cloud AI Research 最近把这层东西做成了一个可开源的框架 Harness²,Apache-2.0 许可,核心主张只有一句:冻结模型权重,只改装备。
为什么这件事值得关注?因为绝大多数企业根本改不了权重。用闭源 API 的改不了,没有标注团队的改不了,算力预算有限的也改不了。微调还有第三个隐性代价:灾难性遗忘——为了学会新任务,把原来的能力弄丢了。harness 路线绕开了这三道门槛,它优化的是「怎么用」,不是「模型是谁」。
再往下追问一层:harness 和过去几年流行的「提示词工程」「RAG」是什么关系?提示词工程是它的一个子集,RAG 更像记忆与工具指导的一种实现方式。把两者放进八个组件的框架里看,很多争论会自然消解——问题不是「RAG 有没有用」,而是「在这个任务里,检索应该放在记忆层还是工具层」。框架的价值,往往就在于它让争论有了共同的坐标系。
八个零件:harness 到底包含什么
Harness² 把 harness 拆成八个可编辑组件。这个拆法本身比框架更有价值,因为它给了团队一张「可改清单」——当智能体表现不好时,你知道该去哪个文件里找问题,而不是笼统地说「提示词再调调」。
这八项覆盖了四个层面:进入上下文的内容(提示词、记忆、工具指导)、能做与不能做的边界(护栏)、任务怎么分(子智能体、技能)、循环里发生了什么(脚本、插件)。很多团队只改第一层,所以总是遇到「提示词写到极限,还是不稳定」的天花板。
一个容易忽视的细节是「脚本」。让模型做算术、做日期推算、做单位换算,本质上是让它用最不擅长的方式做最需要确定性的工作。把这些交给脚本,模型只负责判断「什么时候调用」,稳定性会明显不一样。这也是 harness 思路的核心:把不确定的部分留给模型,把确定的部分交给代码。
- 系统提示词:定义角色、目标与基础规则,决定它「以为自己是干什么的」
- 护栏:划出不能碰的边界,比如不能删除数据、不能对外付款、不能承诺价格
- 记忆:跨任务保留的经验与上下文,决定它会不会在同一个坑里摔两次
- 工具指导:每个工具怎么用、参数怎么填、什么情况下不要用
- 子智能体:把复杂任务拆给专用的小智能体,避免一个上下文塞进所有事
- 技能:针对固定场景固化的操作步骤,相当于可复用的「招式」
- 脚本:可以执行的辅助代码,用来做确定性计算,而不是让模型心算
- 插件:接进工具循环的中间件,负责日志、限流、脱敏这类横切逻辑
提示词只是八分之一。智能体不稳定,先别怀疑模型,先数一数这八个零件你改过几个。
第一层递归:没有标准答案时,怎么判断改得好不好
真实业务里,大多数任务没有标准答案。一份合同摘要写得好不好,一条客服回复是否得体,很难用一个分数判定。没有 ground truth(标准答案),自动优化就失去了目标函数——这正是过去「让 AI 自己改提示词」大多失败的原因。
Harness² 的做法是换一个判据:不比「对不对」,比「哪套装备更好」。它把这套机制叫 PPC——提议(Propose)、探测(Probe)、组合(Compose)。先分析执行轨迹,针对卡点提出多个修改方案;再让换上不同装备的智能体在同一个任务上真跑一遍,对比执行结果;最后把表现最好的改法合并成当前任务的版本。
这个思路的巧妙之处在于,它把「评价」变成了「对比」。单看一个结果很难打分,但两个结果放在一起,人也好、模型也好,都更容易判断哪个更接近目标。框架支持并行与顺序两种递归:并行是同时探索多个候选,顺序是一步步加深。前者适合预算充足、想快速找到方向;后者适合任务复杂、需要逐层收敛。
两种模式的选择,说到底是预算与精度的取舍。并行像撒网,一次跑五套候选,总有一套能中,但成本乘以五;顺序像挖井,每一步只改一点,看得清哪一步起了作用,但轮次多、周期长。真实项目里更常见的做法是先用并行找方向,再用顺序做收敛——先宽后窄,别一开始就钻牛角尖。
第二层递归:把一次成功,蒸馏成下一次的起点
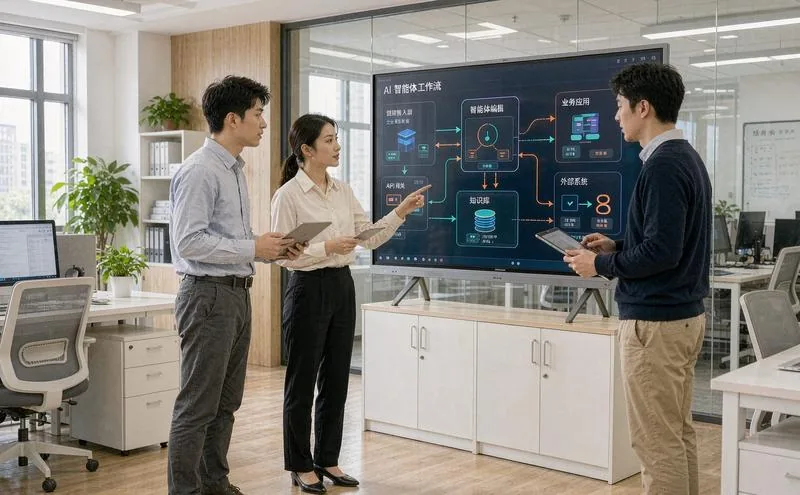
如果只有第一层,Harness² 只是一个自动调参工具:这次调好了,下次换个任务又从零开始。真正让它和普通提示词优化区分开的,是第二层——harness 级递归。
每完成一次任务级优化,框架会从成功轨迹里提取一条可复用的经验,连同支撑它的执行记录一起存进文件。比如「处理表格类任务时,先用脚本清洗空值,成功率更高」——这不是一句泛泛的建议,它背后有具体的任务、具体的失败样例、具体的对比结果。下一个任务开始时,框架先检索相关经验,再决定怎么改装备。
这有点像老师傅带徒弟:不是把全部知识灌进去,而是把「这一类活儿该怎么下手」沉淀成几条可查的规矩。区别在于,人的经验会随离职流失,文件不会。对组织来说,这意味着智能体的能力可以积累——今年调好的东西,明年还在,换个人接手也还在。
组织的智能体能力,应该沉淀在版本化的文件里,而不是某个人的手感里。手感会走,文件不会。
三组数字与它们的边界
论文给出的结果,是在权重冻结、不使用标准答案、只做单步优化的条件下得到的:WorkBuddy-Bench 提升 11.5 分,JobBench 提升 4.5 分,LAB 准确率提升 11.8 个百分点。测试模型包括 Gemini 3.5 Flash 与 GLM-5,说明增益来自 harness,而不是某一个特定模型。
这三个数字要分开看。WorkBuddy-Bench 考察的是复杂办公流程中的协作,提升最大,说明 harness 对「多步骤、多工具、需要拆解」的任务最有效;JobBench 更接近日常职业任务,提升 4.5 分,属于稳健但不夸张;LAB 是硬核专业任务,11.8 个百分点说明在长链条推理里,装备的差距会被放大。
边界同样要说清楚。第一,这些是基准测试,不是你的业务;你的任务分布、数据质量、工具成熟度都和论文不同,不能把 11.5 分直接搬进预算。第二,单步优化就有增益,但继续增加递归轮次 k 会继续提升,同时成本也上升——提升不是免费的。第三,基准上的「更好」未必等于业务上的「更稳」,有些场景需要的是确定性,而不是平均分。
把基准分数当上限,而不是当承诺。真正的收益,要在你自己的三十条脏数据上量出来。
为什么企业更该关心 harness,而不是权重
模型的生命周期正在变短。三个月一次大版本,一个月一次小迭代,今天调好的提示词,下个月可能因为模型行为变化而失效。如果企业的能力全部押在「用哪个模型」上,每次换代都要重新交学费。
harness 不一样。工具清单、权限边界、失败处理、经验文件,这些东西跟着业务走,不跟着模型走。换模型时,只需要重新跑一遍评测集,看哪些装备需要微调,而不是把整套系统推倒重来。对使用闭源 API 的企业,这几乎是唯一可积累的资产。
采购视角也需要跟着变。过去验收看「接入了哪个模型」,以后应该看「工具清单是否完整、权限是否可管、失败是否可回放、经验是否可迁移」。一个能说清这四件事的供应商,比一个只会报模型参数的供应商更值得签长约。
还有一个组织层面的理由。模型能力是公共品,谁都能买到;harness 是私有品,只有你自己的业务能长出来。当同行都在用同一个模型时,差异就落在工具清单、失败处理和经验的厚度上。这也是为什么一些团队已经把 harness 配置纳入代码评审——它已经是生产资产,不再是几个随手改的提示词。
- 工具清单:能不能列出每个工具的用途、参数、失败码与替代方案
- 权限边界:智能体能做什么、不能做什么,是否可配置、可审计
- 失败回放:一次失败能否完整重放,定位到工具、参数还是模型判断
- 经验迁移:换模型后,历史经验与评测集能否继续使用
三个坑:探测成本、过拟合自家评测、自我修改失去护栏
第一个坑是探测成本。PPC 的每一步都要真跑:提出三个改法,就要跑三遍;递归五轮,就是十五遍。任务越复杂、工具越多,单次执行越贵。很多团队算完账会发现,harness 优化省下的是微调成本,不是推理成本——它让「不改模型」成为可能,但没让「多跑几遍」变免费。
第二个坑是过拟合。用二十条自家用例调 harness,调到 95% 成功率并不难,难的是换一批真实输入还能不能保持。必须留出 holdout 集,最好按时间切分——用上个月的数据调,用这个月的数据验,而不是随机打乱。否则你优化出来的是一套「应付考试」的装备。
第三个坑最危险:让模型改自己的护栏。护栏是八组件之一,理论上可以被优化;但一旦允许智能体自行放宽边界,等于让它修改约束自己的法律。正确做法是把护栏设为只读,或者必须人工审批、版本化、可回滚。自我改进的前提,是有一块它不能碰的地板。
落地路径:从一条 trace 开始的两周计划
如果想试,不必一上来就复现论文。选一个高频、能判断对错、失败代价可控的任务——比如把会议纪要整理成待办、把客户邮件归类到工单、把对账差异定位到具体单据。准备三十条真实输入,其中至少十条是「脏」的。这是你的基线,也是未来所有对比的起点。
两周之后,你大概率拿不到 11 分的提升,但会得到三个更有用的东西:一套可复现的评测方法、一份知道哪里会坏的失败清单、一条「改了之后有没有变好」的判断链路。这三样东西,比任何单次提升都更难被复制。
Harness² 的意义,也许不在于它具体提了多少分,而在于它把「智能体工程」从玄学变成了有零件、有流程、有账可算的活儿。模型会继续换代,装备会继续积累——后者才是企业真正能留住的部分。
- 第 1 至 3 天:固定模型与参数,跑完三十条,记录成功率、平均耗时、失败类型
- 第 4 至 7 天:只改工具指导与记忆两个组件,其余不动,形成第二版
- 第 8 至 10 天:两版在同一批输入上对比,重点看失败类型有没有变化
- 第 11 至 14 天:把有效改法写成经验条目,接入下一批任务;同时留出 holdout 集
把趋势落成系统
文中反复强调的前提——数据在线化、流程结构化——正是下面这些系统在解决的事
常见问题
不是替代,是分工。微调改变模型的行为倾向,适合有大量标注数据、且模型能力确实缺一块的场景;harness 优化改变模型的使用方式,适合工具多、流程长、模型能力够但用不好的场景。多数企业的真实瓶颈在后者:模型能答,但不知道怎么调工具、不知道什么时候该问人。先做 harness,再评估是否需要微调,通常更省钱。两者也可以叠加,但要先有稳定的评测集,否则无法判断收益来自哪一层。
看懂了趋势,下一步是选对系统
告诉我们你的行业、团队规模和最想自动化的环节,我们从 406 条产品线里帮你匹配合适的管理系统, 或按需求定制开发——并为 AI 接入预留好规范的数据接口。
7×24小时在线
把文章里的思路,落成你的系统方案
留下行业与业务规模,我们免费给出针对性的选型建议与实施路径
服务保障
- 免费需求分析
- 按行业匹配系统
- 实施方案透明
- 7×24 技术支持